今日要点
- DeepSeek 开源生产推理引擎 DeepInfer:撑起 DeepSeek-V4.1-Flash 线上服务的推理框架以 Apache-2.0 开源,跑在 NVIDIA SM100 和华为昇腾 950 上。
- Codex 额度风波有了解释:OpenAI 称约 40,000 个账户实际套用的用量上限和所选套餐对不上,已修复并逐一补额度。
- TypeScript 编译器有了 Rust 版:Cloudflare 和 VoidZero 推出 tsrs,同等配置下比 TS 7.0 快最多 8 倍、内存少约 70%;@steipete 说自己的项目已换上,快了约 5 倍。
1. DeepSeek:开源生产推理引擎 DeepInfer
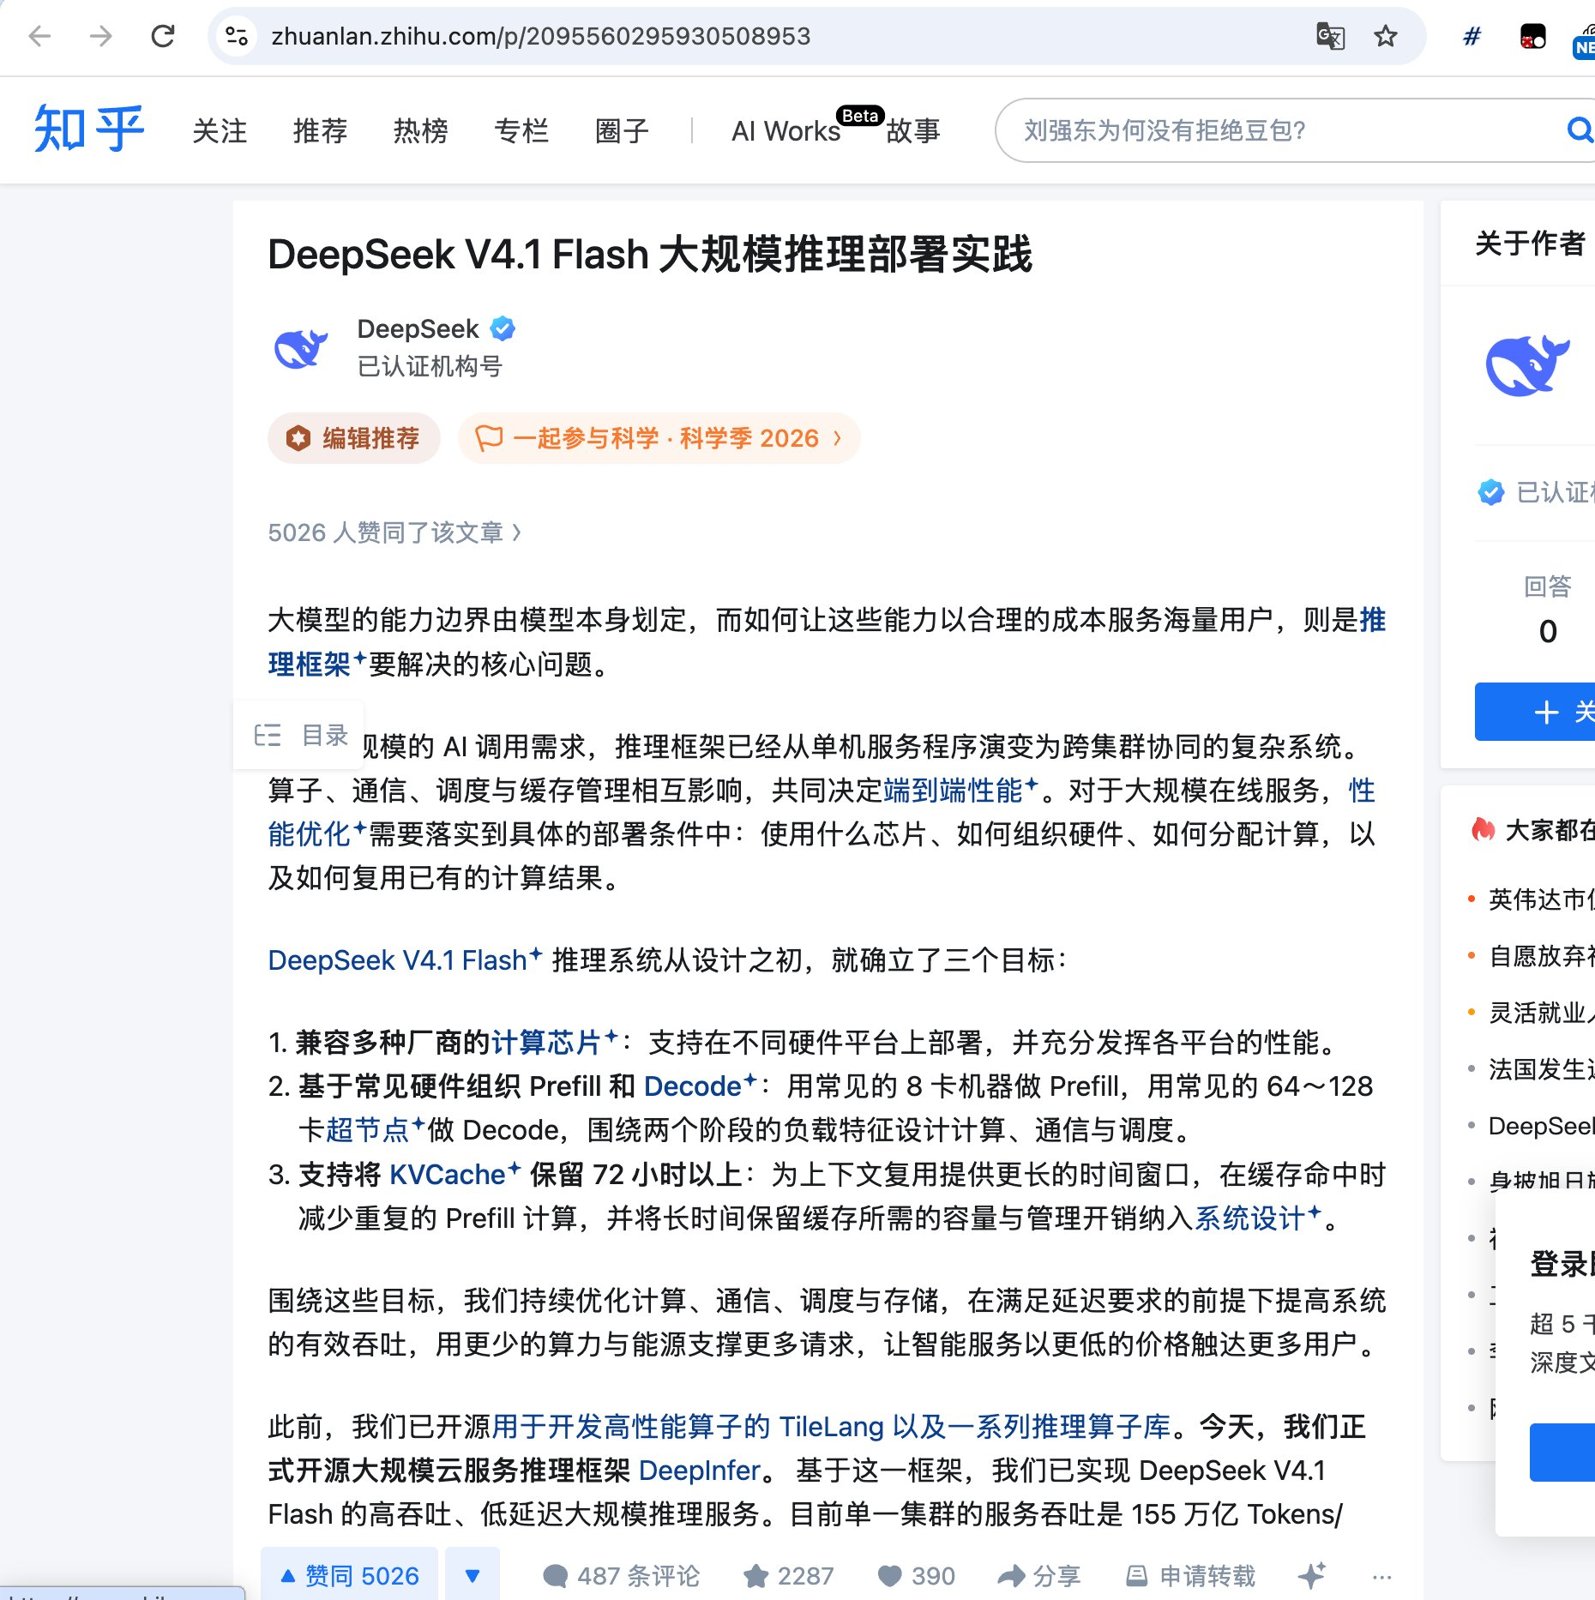
要点:@deepseek_ai 宣布开源 DeepInfer,称这是支撑 DeepSeek-V4.1-Flash 大规模线上服务的自研推理框架,目的是帮社区「降低算力成本和能耗」(3.2 万赞)。GitHub 仓库 deepseek-ai/DeepInfer 采用 Apache-2.0 许可;README 写明目前只支持 DeepSeek-V4.1-Flash、只提供离线推理,硬件支持 NVIDIA SM100 和 华为昇腾 950,特性包括 Attention DP、MoE EP + EPLB、投机解码(DSpark)、批次无关推理、确定性采样和结构化输出;完整线上服务需要的 KV cache 系统、Prefill/Decode 分离和副本间负载均衡不在这次开源范围内。@swyx 指出 DeepSeek 在知乎上写得更多:按其引用,基于这套框架的 V4.1 Flash 服务单集群吞吐达每天 155 万亿 token、按闲时价格每卡每小时收入 38 美元;他据此估算 DeepSeek 按自己的定价也有约八成服务毛利(swyx 的推算,非官方数字)。
为何值得看:开源的是「线上真在用的那套」推理栈而不是参考实现,而且同时适配昇腾,这对自建部署和国产算力生态都是实打实的参考;不过缺了 KV cache 和调度层,想复刻 DeepSeek 的线上成本还差几块。
- deepseek_ai:DeepInfer 开源:https://x.com/deepseek_ai/status/2112476496283775135
- swyx:知乎上的吞吐和收入数字:https://x.com/swyx/status/2112587397380943953
2. Codex:约 4 万账户用量上限算错,官方道歉补额度
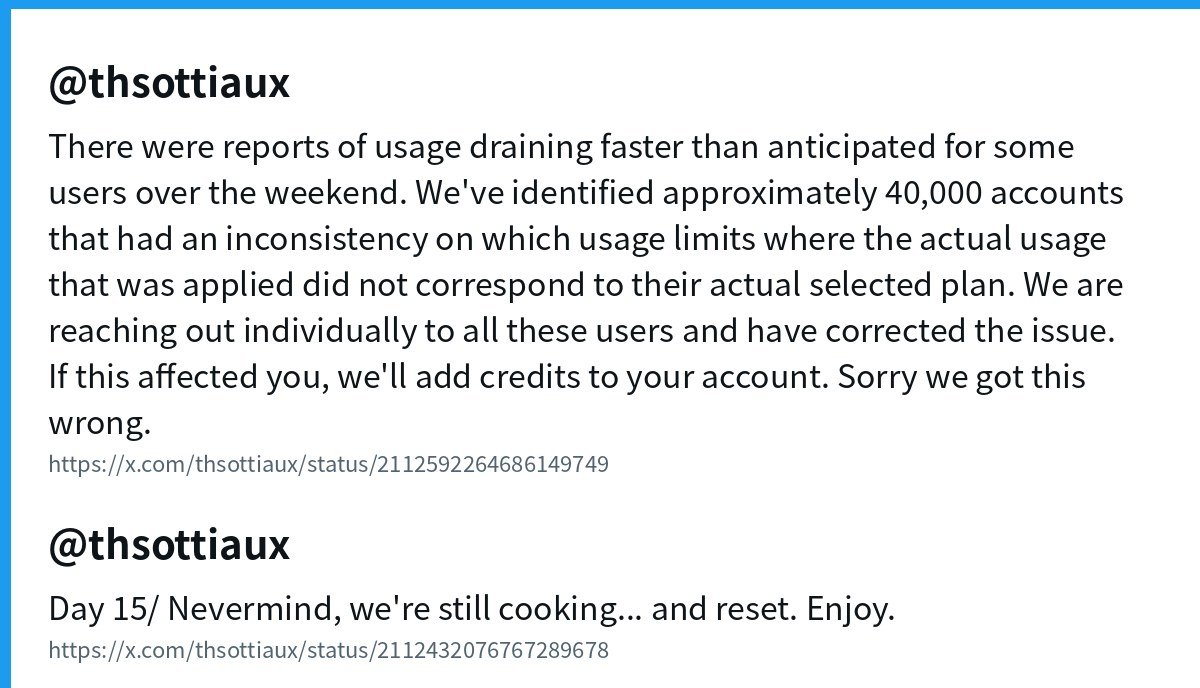
要点:针对周末「额度掉得比预期快」的反馈,Codex 负责人 @thsottiaux 说团队定位到约 40,000 个账户:实际套用的用量上限与用户所选套餐不一致;问题已修复,会逐一联系受影响用户并补额度,「Sorry we got this wrong」(8.9k 赞)。同一天他还发了「Day 15」:前一晚刚说「we're cooked」,随后又改口「still cooking」,给所有人再重置了一次额度(1.1 万赞)。也有用户不买账:@mkeremturhan 发长文说用户抱怨额度「几分钟就没了」已有几周,并列举了 GPT-6 Astra 写代码太耗额度、修复-测试循环空耗重试等问题(均为该用户的说法),要求「先修好计量,别再发重置卡」。
为何值得看:订阅制 coding agent 的核心体验其实是「额度可预期」;连续多天的重置能换来好感,但计量本身出错,伤的是信任。
- thsottiaux:约 4 万账户额度不一致,补偿:https://x.com/thsottiaux/status/2112592264686149749
- thsottiaux:Day 15,再次重置:https://x.com/thsottiaux/status/2112432076767289678
- mkeremturhan:用户的公开信:https://x.com/mkeremturhan/status/2112638419721417126
3. tsrs:TypeScript 编译器的 Rust 移植,最多快 8 倍
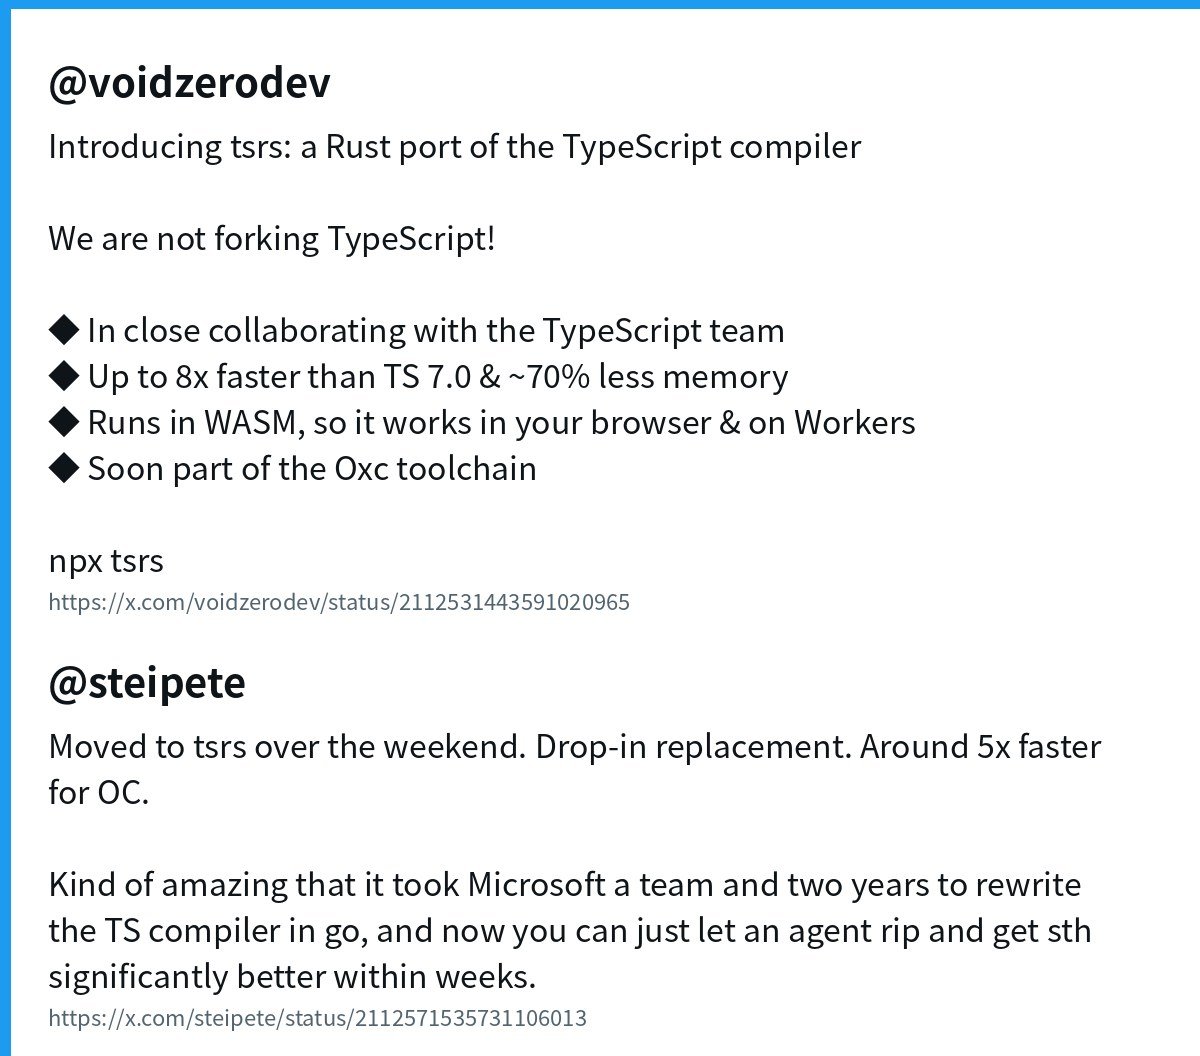
要点:@voidzerodev 发布 tsrs,一个 TypeScript 编译器的 Rust 移植(4k 赞)。按 Cloudflare 博客,这是 Cloudflare、VoidZero 和 Owner.com 的 Max Schwenk 合作的项目,与 TypeScript 团队密切配合,明确不分叉 TypeScript,语言设计仍由 TS 团队决定;早期基准显示,在相同类型检查 worker 数下比 TypeScript 7.0 快最多 8 倍、内存少约 70%,部分优化已回馈给 TS 7.1 beta(比 7.0 快最多 2.5 倍)。因为是 Rust,它能编进 WASM,在浏览器和 Workers 里跑,之后会并入 Oxc 工具链;博客还说正与 Theo Browne 商量把 tsc-rs 和 tsrs 合并成一个包,并用 agent 每天跟踪上游变更。@steipete 说周末已经把自己的项目切到 tsrs,「直接替换,快了大约 5 倍」,并感叹微软用一个团队花两年把 TS 编译器移植到 Go,现在「让 agent 放开跑,几周就能拿到明显更好的东西」。
为何值得看:前沿模型让「大规模语言移植」从多年工程变成几周的事,真正的难点转向了和上游保持一致;tsrs 选择「跟 TS 团队合作 + agent 持续同步」,是这类移植可持续的一种做法。
- voidzerodev:tsrs 发布:https://x.com/voidzerodev/status/2112531443591020965
- steipete:已切换,约快 5 倍:https://x.com/steipete/status/2112571535731106013
4. OpenAI:12 小时 prompt 缓存、团队定时任务、收购 Orchestra Bio
要点:@OpenAIDevs 宣布 API 支持选择 12 小时 prompt 缓存:像 dots 这样常驻的 agent 一整天反复用同一份指令、工具和上下文,即使请求间隔几个小时,也能按更低的缓存输入价计费(2k 赞)。ChatGPT 上线「team tasks」,可以把每周五汇总「上线了什么、卡在哪」这类重复工作自动化,团队成员能审阅结果、调整下一次覆盖的内容(1.3k 赞)。@OpenAI 宣布收购 Orchestra Bio,一个帮药企协调药物研发流程的平台,将并入其生命科学模型和工具 Rosalind(5k 赞)。另外,@sama 确认 Aleksander Madry 回到 OpenAI,负责安全与安保方向的工作;Madry 自己的说法是,原以为的离职「更像是一次休假」。
为何值得看:12 小时缓存直接对着「全天在线的 agent」定价,说明常驻 agent 已经是 OpenAI 认真对待的用量形态。
- OpenAIDevs:12 小时 prompt 缓存:https://x.com/OpenAIDevs/status/2112603916076781778
- OpenAIDevs:ChatGPT team tasks:https://x.com/OpenAIDevs/status/2112565702552940794
- OpenAI:收购 Orchestra Bio:https://x.com/OpenAI/status/2112607347688583586
- sama:Aleksander Madry 回归:https://x.com/sama/status/2112652656602923366
5. Claude / Anthropic:Claude 设计蝎毒结合蛋白,Opus 5.5 用量吃紧
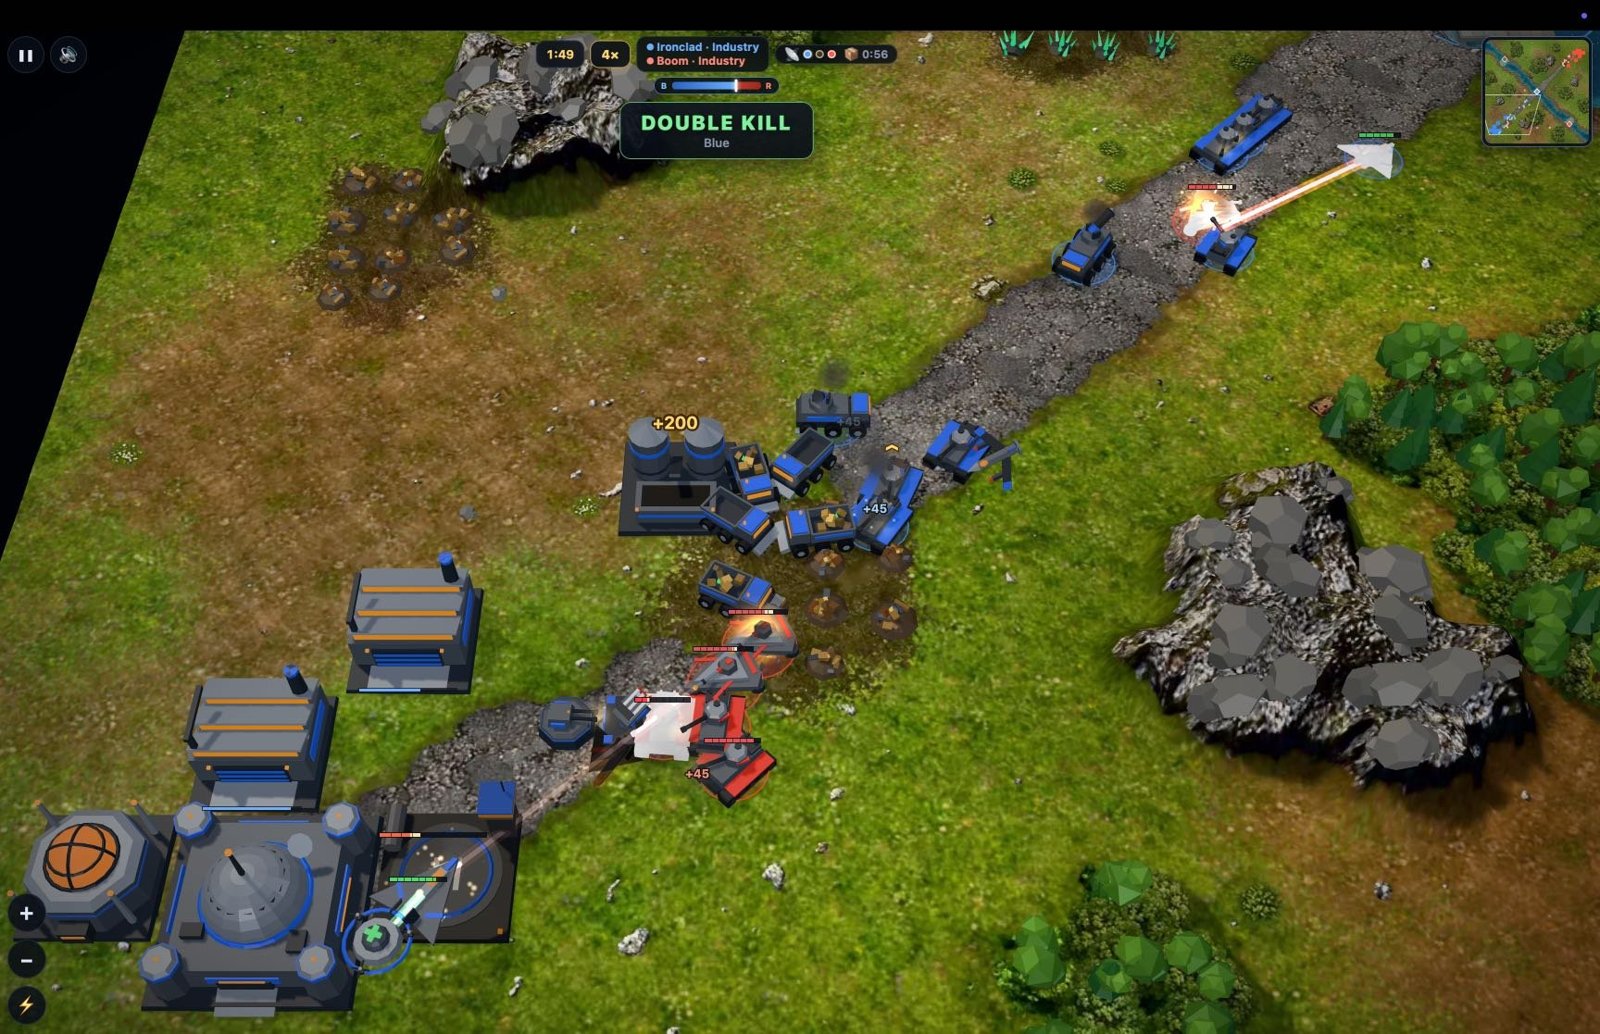
要点:@AnthropicAI 在科学博客发布一项实验:内部研究模型在 Claude Science 环境里用约 64 小时、基本自主地设计针对蝎子神经毒素的小型结合蛋白,共生成 318,484 个设计,最终 211 个送去两家实验室测试,17 个达到结合标准;Anthropic 明确说还没验证能否中和毒液,「不声称做出了抗毒血清」,并公开了全部 211 个设计和数据(5k 赞)。开发者这边,Opus 5.5 的讨论集中在「好用但贵」:@marouane53 说 Opus 5.5 刚出时 Claude Code 感觉几乎不限量,他因此停了 200 美元的 Codex 套餐,几周后两个 Claude Code Max 订阅 3 天就都用完(1.4k 赞);@theo 发视频说 Opus 5.5 证明「世界确实需要更聪明的模型」;@simonw 主要用 Opus 5.5 做了一款浏览器里的即时战略游戏 Battle Drones,3D 模型都由 Claude 用 Three.js 生成,还支持通过声音做设备间联机。
为何值得看:一边是模型在长时间自主科研上交出可复核的实验结果,一边是重度用户撞上额度墙;能力往上走的同时,「用得起多少」成了同样重要的问题。
- AnthropicAI:蝎毒结合蛋白设计:https://x.com/AnthropicAI/status/2112579251555721573
- marouane53:两个 Max 订阅 3 天用完:https://x.com/marouane53/status/2112501048711508232
- theo:「世界确实需要更聪明的模型」:https://x.com/theo/status/2112671665088024744
- simonw:用 Opus 5.5 做的 Battle Drones:https://x.com/simonw/status/2112630778068881543
6. Grok Bot:一段视频看完近期更新,在 X 上直接 @ 它
要点:@mattyp 发了一段4 分多钟的「What's new in Grok Bot」视频,按时间轴过了一遍近期更新:新的聊天卡片、速度提升、草稿编辑、邮箱别名、X 私信、在 X 上 @bot、连接器、语音通话、通知、邀请与 Android 助手,以及访问名单、未读、定时任务和登录(4k 赞、2k 收藏)。@poteto 转发 Geoffrey Huntley 的用法说,他最喜欢的功能之一就是在 X 上直接 @ 它,让它读完一条帖子的回复并整理成一个新的 bot。
为何值得看:把 agent 放进人们已经在用的地方(X、私信、邮件、电话),是 Grok Bot 这类个人 agent 的主要打法。
- mattyp:What's new in Grok Bot:https://x.com/mattyp/status/2112550158885917122
- poteto:在 X 上 @ 它:https://x.com/poteto/status/2112606908893053223
7. Agent 基础设施:Vercel durable-harness,Reason Network 开源
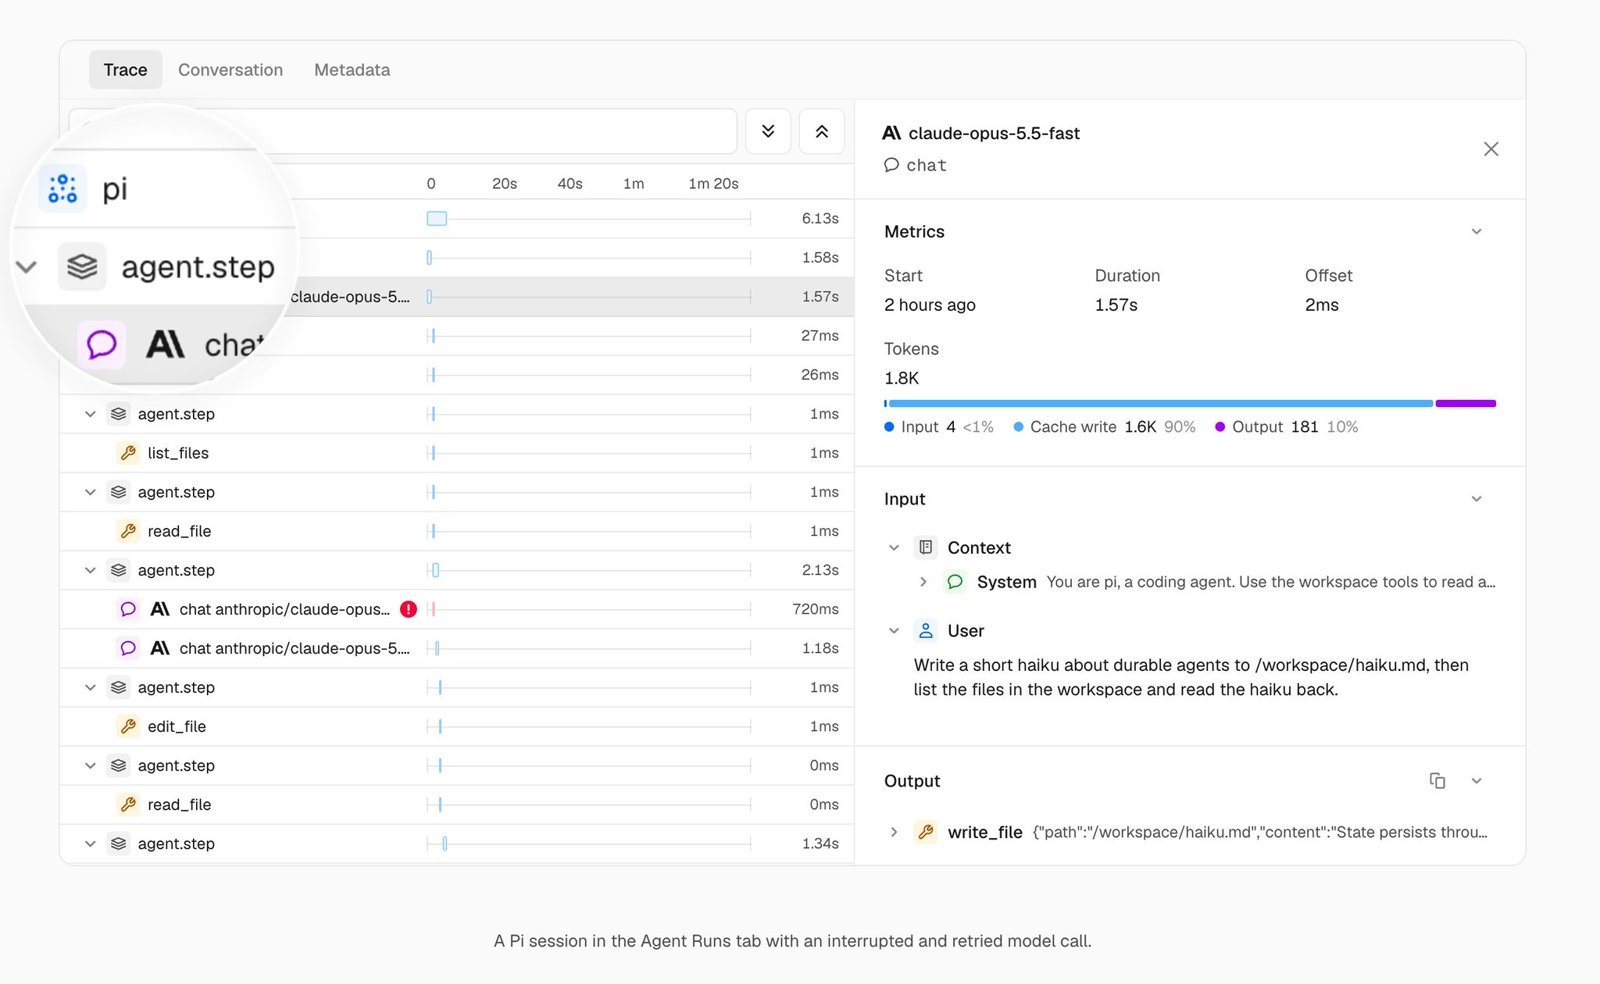
要点:@vercel 推出开源的 durable-harness,让 Pi、OpenCode、Codex、Claude Code 等 harness 在 Vercel、自建 Postgres 或本机上「耐久」运行:每次模型调用和工具调用前记下意图、完成后记下结果,函数崩溃或超时后由新函数读日志接着跑,已完成的模型调用不会重复计费;工具可以标记 replay: 'safe' 或 'never',避免退款、发评论这类操作执行两次(500 赞、近 400 收藏)。@rauchg 补充说,Claude Code 和 Codex 也能这样变得可恢复、可观测,但它们目前不是为嵌入设计的,需要额外的沙箱,效率和可移植性不如 Pi 或 fx。另一边,@reasonmachines 发布 Reason Network OSS,让 Claude Code、Codex、Grok Bot 等 agent 之间点对点加密通信,GitHub 仓库为 Apache-2.0(1.4k 赞、2.1k 收藏)。
为何值得看:agent 从本地终端搬到云上长期运行,「崩了能接着跑」和「彼此能对话」成了新的基础设施需求。
- vercel:durable-harness:https://x.com/vercel/status/2112653833382027729
- rauchg:Claude Code / Codex 也能耐久运行:https://x.com/rauchg/status/2112658577110520122
- reasonmachines:Reason Network OSS:https://x.com/reasonmachines/status/2112539998352523575
8. Agent 长跑:OpenClaw 约 600 个 PR 换前端框架,theo 一夜 CI 崩盘
要点:@steipete 说两周前启动了一个 loop,把 OpenClaw 基于 Lit 的 Web 前端迁移到 Solid 2.0:大约 6 天后移除了 Lit,又用一周把代码改成地道的 Solid 写法,他每隔一天看一次进度,「整体基本是自动的」,总共约 600 个 PR,结果是 JS/CSS 体积更小、更新更细粒度。@theo 则讲了反面:一晚上「vibe coding 出来的各个部分在眼前全部崩掉」,让他意识到「工程师依然非常、非常必要」(4.8k 赞);但他随后补充,问题大多来自老旧依赖、GitHub Actions 和涉及 Chromium 驱动的不稳定测试,反倒是 AI 写的部分很稳定。同一天他还说自己 vibe code 了一个 Cargo 替代品,编译他的 Rust 应用最多快 129 倍,「第一反应却是:那又怎样?」。
为何值得看:长时间跑的 agent loop 已经能啃下整框架迁移,但卡人的往往是 CI、外部依赖这些「老问题」;工程判断的位置在变,不是消失。
- steipete:OpenClaw 迁到 Solid 2.0:https://x.com/steipete/status/2112597162924351909
- theo:「工程师依然非常必要」:https://x.com/theo/status/2112492504511832509
- theo:问题多在老依赖和 CI:https://x.com/theo/status/2112670864894550182
- theo:vibe code 的 Cargo 替代品:https://x.com/theo/status/2112675779410895305
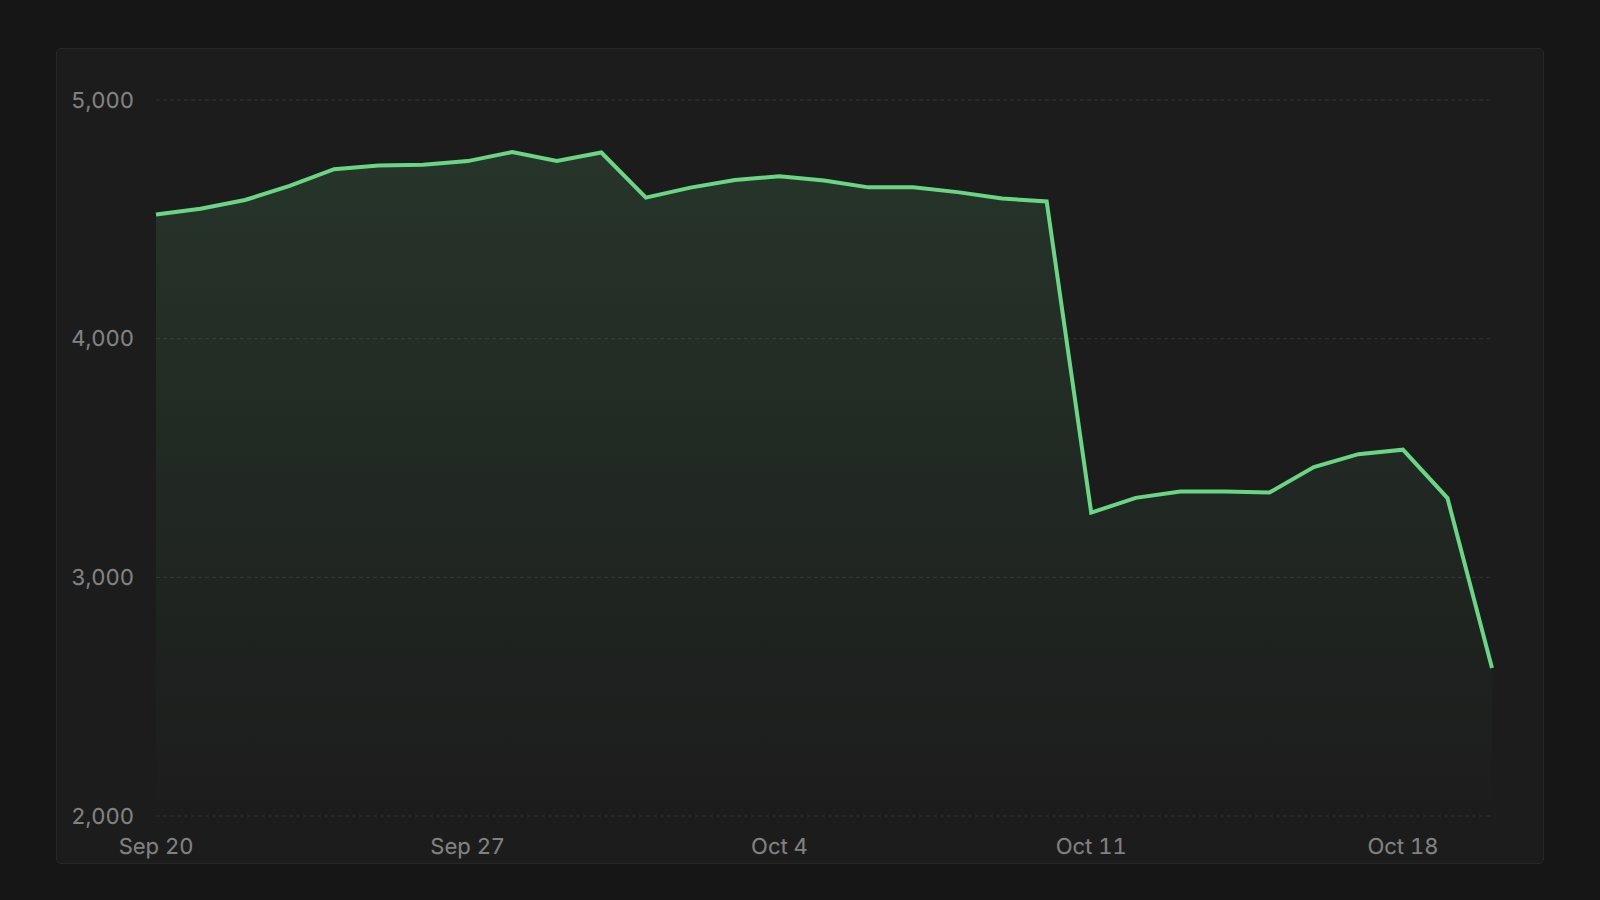
9. 编码 agent 客户端:OpenCode 2.0 后集中清 issue,T3 Code 日均 450 万轮
要点:@thdxr 说 OpenCode 2.0 之前占用了团队大量精力,因此被批评没处理 issue,现在 2.0 发布后「团队在疯狂清 issue」,配图是 issue 数量曲线(1.4k 赞)。他还谈到开源 PR 的新问题:外部 PR 不知道用的是什么模型,而团队内部给 agent 的工具更好,所以这类 PR「几乎总是不如我们自己发 prompt」,主要价值在于他们无法复现的环境。@theo 公布 T3 Code 用户现在每天完成超过 450 万轮对话,并说用量增长比用户数增长还快。
为何值得看:当维护者自己的 agent 比贡献者的更好用,开源贡献的形态可能从「提交代码」转向「提交问题和环境」。
- thdxr:OpenCode 2.0 后清 issue:https://x.com/thdxr/status/2112544276647231836
- thdxr:外部 PR 不如自己发 prompt:https://x.com/thdxr/status/2112538272601616551
- theo:T3 Code 日均 450 万轮:https://x.com/theo/status/2112678372128231766
10. Artificial Analysis:同等智能的成本一年降了几十倍,最强模型却更贵
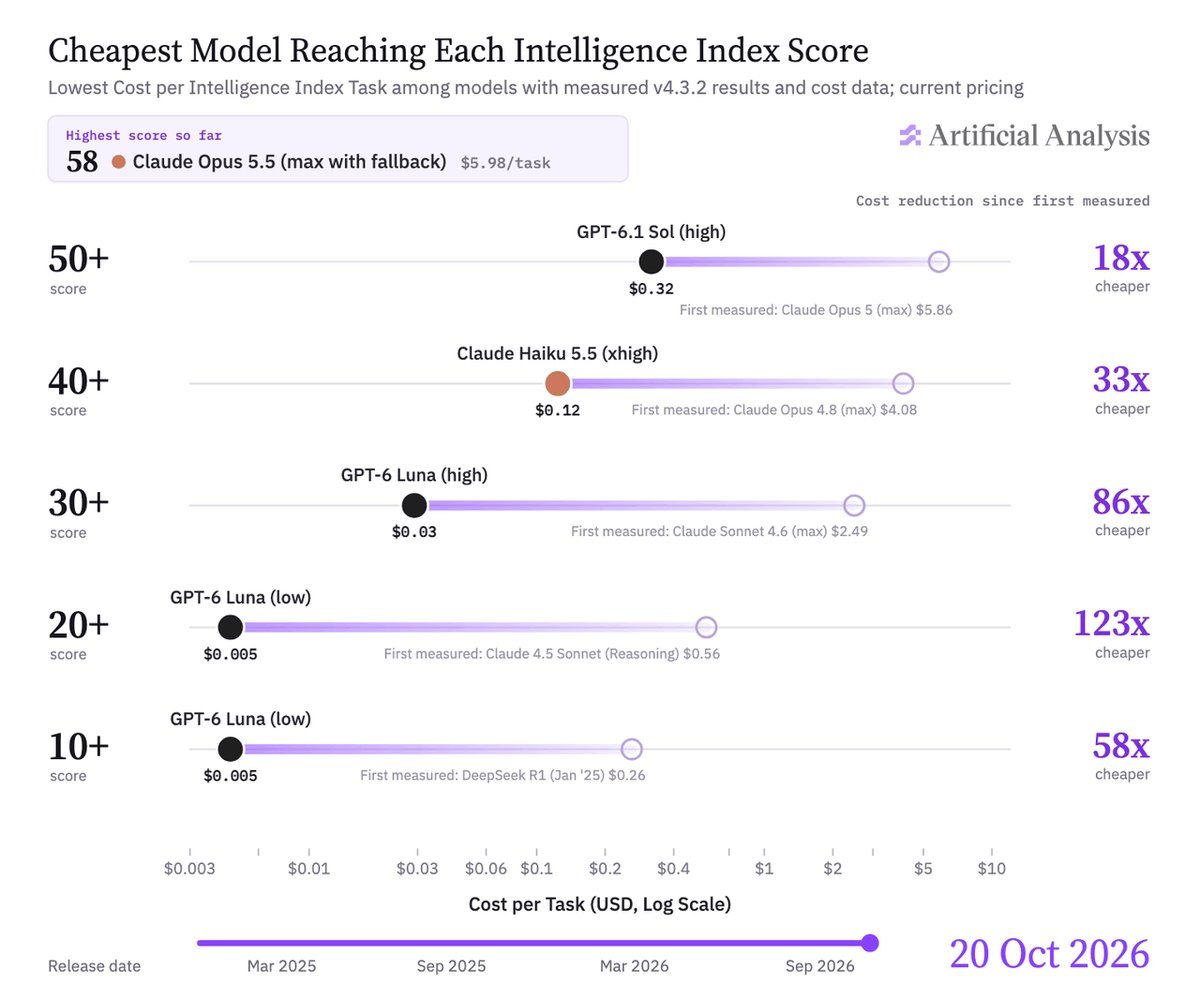
要点:@ArtificialAnlys 发布成本分析:在其智能指数上达到 30 分,现在的单任务成本比首次达到时低 86 倍——GPT-6 Luna(high)每任务 $0.03,而 2026 年 2 月首次达到 30 分的 Claude Sonnet 4.6 是 $2.49;达到 20 分便宜了 123 倍,达到 40 分便宜了 33 倍,Claude Haiku 5.5(xhigh)以 41 分、每任务 $0.12 成为达到 40 分最便宜的模型。与此同时,最高分一年内从 21 升到 58,成本约为原来的 11 倍,Claude Opus 5.5 每任务 $5.98。同一天它还发布模型「性格」聚类:按 30 项特征,Anthropic 模型和 OpenAI 的 GPT-6 系列归为一类,Google 和 Meta Muse 一类。
为何值得看:「同等能力越来越便宜、最强能力越来越贵」解释了为什么一边是便宜模型价格战,一边是重度用户频繁撞额度。
- ArtificialAnlys:达到各分数线的成本变化:https://x.com/ArtificialAnlys/status/2112582116651466965
- ArtificialAnlys:模型性格聚类:https://x.com/ArtificialAnlys/status/2112578038990835765