今日要点
- Space Bunny 揭晓:MiniMax M3.1 Flash:在用量榜上跑了 200T+ token 的匿名模型,原来是 M3.1 Flash 的早期版本;API 每百万 token 输入 $0.15、输出 $0.60,权重 10 月 23 日放出,Qoder、Cline、Vercel AI Gateway 首日接入。
- 美国国土安全部下令移除 DeepSeek:DHS 要求联邦民用机构停止采购、并从 IT 系统中移除 DeepSeek 产品,范围包括「基于 DeepSeek 实现开发的第三方产品和服务」。
- OpenAI 新模型啃下 COBOL:GPT-6 Astra 在 MultiLangBench 上 20 种语言平均通过率 87.4%,GPT-6.1 Sol 的 COBOL 迁移准确率高推理档达 97.9%;同时 OpenAI 帮 OpenCode 受攻击用户退回了被盗刷的额度。
1. MiniMax M3.1 Flash:Space Bunny 揭晓身份,三家工具首日接入
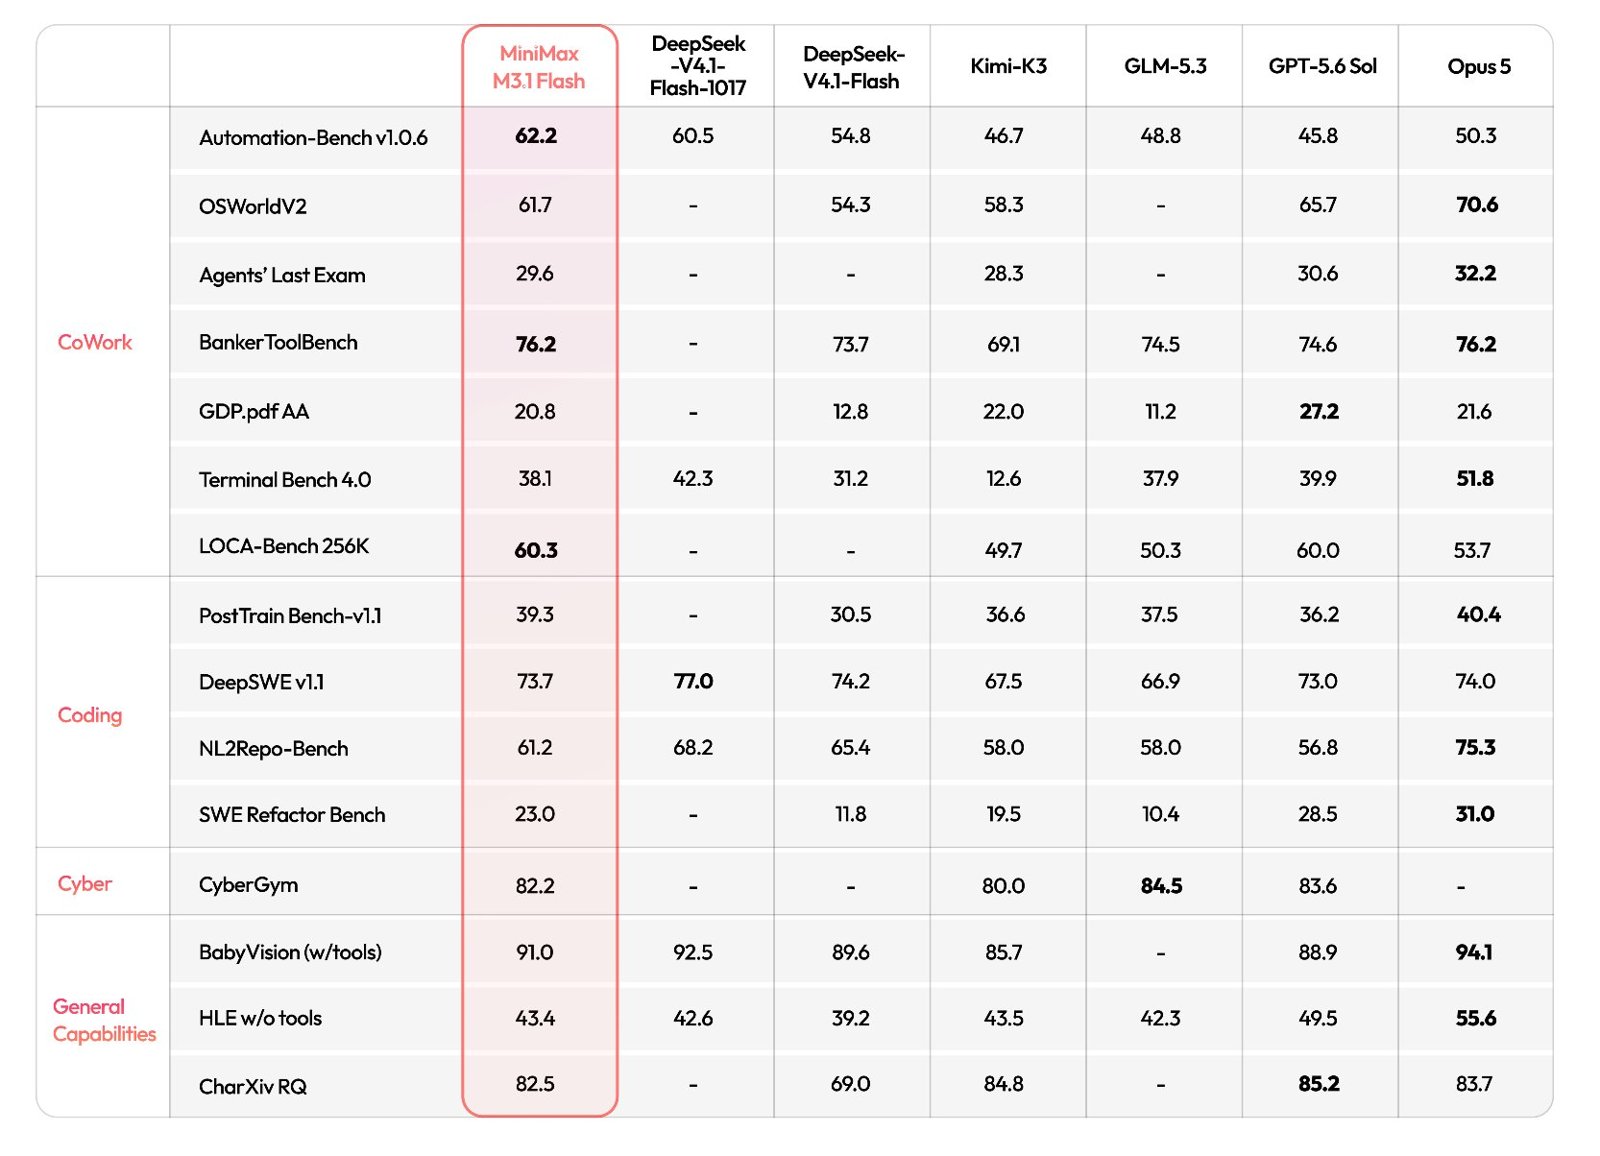
要点:@MiniMax_AI 发布 M3.1 Flash,并确认最近在全球用量榜上排第一、累计跑了 200T+ token 的匿名模型 Space Bunny,就是它的早期版本。官方给出的成绩(均为自报):Automation-Bench 62%、ALE 30%、DeepSWE 74%、BabyVision 91%;成本是 M3 的 1/3,速度是 3 倍。API 统一定价每百万 token 输入 $0.15、输出 $0.60,缓存读取 $0.015;模型权重 10 月 23 日放出。这条 6.4k 赞、近 89 万浏览。工具方当天跟进:@qoder_ai_ide 首日上线,称「快近 3 倍、便宜 70%」;@cline 称它在 coding 上和 Opus、GPT「打得有来有回」,成本约低 25 倍(Cline 的说法),并在 Cline 里免费;@vercel_dev 把它上架 AI Gateway,由 MiniMax 提供服务时免费到 10 月 22 日,@rauchg 转发说「More free AI」。
为何值得看:先匿名上榜攒真实用量、再揭晓身份,正在变成模型发布的常见套路;每百万输入 $0.15 的价格加上即将开放的权重,会继续压低 agent 场景的 token 成本。
- MiniMax_AI:M3.1 Flash 发布,Space Bunny 揭晓:https://x.com/MiniMax_AI/status/2112150867868541221
- qoder_ai_ide:首日接入:https://x.com/qoder_ai_ide/status/2112188948202344646
- qoder_ai_ide:全套产品可用:https://x.com/qoder_ai_ide/status/2112210708259840091
- cline:在 Cline 里免费:https://x.com/cline/status/2112220504258224605
- vercel_dev:AI Gateway 免费到 10 月 22 日:https://x.com/vercel_dev/status/2112181432307294550
- rauchg:「More free AI」:https://x.com/rauchg/status/2112194000639967590
2. DeepSeek 后续:美国国土安全部下令联邦民用机构移除,国内工具限免
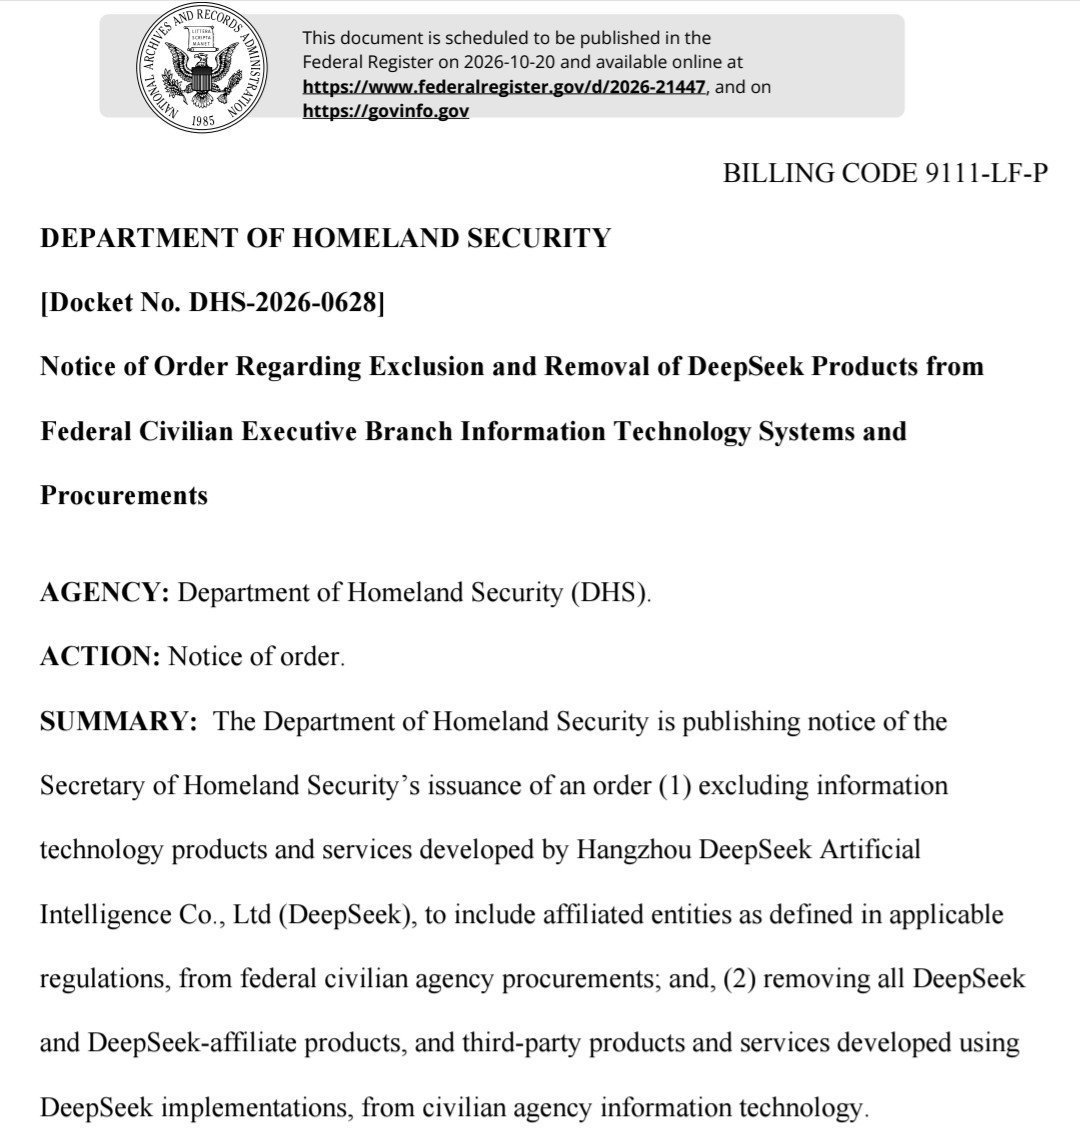
要点:新角度来自监管。@AndrewCurran_ 转述:美国国土安全部(DHS)要求所有联邦民用机构移除 DeepSeek 产品以及「任何基于 DeepSeek 实现开发的第三方服务」,并停止采购(1.5k 赞)。我们核对了 Federal Register 的公开预览文件(FR Doc. 2026-21447,10 月 19 日提交、10 月 20 日正式刊登):命令依据《2018 年联邦采购供应链安全法》(FASCSA),一是把杭州深度求索及其关联实体的 IT 产品和服务排除在联邦民用机构采购之外,二是从民用机构 IT 中移除所有 DeepSeek 及关联方产品,以及用 DeepSeek 实现开发的第三方产品和服务。@nopainkiller 的评价是 DeepSeek 迎来了自己的「华为时刻」。另一边,@qoder_ai_ide 宣布 V4.1-Flash-1017 在 Qoder 里免费用到 10 月 24 日(免费和付费用户都按 0 倍额度计,这条浏览 58 万)。中文圈里,@guansi 把 DeepSeek 新 Flash 提出的「许愿式编程」概括为「所想即所得」,@geniusvczh 引用说这个词「不是我一直在用的吗」。
为何值得看:排除范围写到了「基于 DeepSeek 开发的第三方产品」,给美国政府供应商出了一道合规题:自家产品里有没有用到 DeepSeek 的权重或实现,需要盘点清楚。
- AndrewCurran_:DHS 要求移除 DeepSeek:https://x.com/AndrewCurran_/status/2112250754358788437
- nopainkiller:「华为时刻」及 Federal Register 文件:https://x.com/nopainkiller/status/2112180182744461713
- qoder_ai_ide:Qoder 免费到 10 月 24 日:https://x.com/qoder_ai_ide/status/2112211366954344459
- guansi:「许愿式编程」即「所想即所得」:https://x.com/guansi/status/2112146893166018614
- geniusvczh:这个词我一直在用:https://x.com/geniusvczh/status/2112165044561891332
3. OpenAI / Codex:低资源语言大幅进步,Codex 可以改历史消息,OpenCode 用户获退款
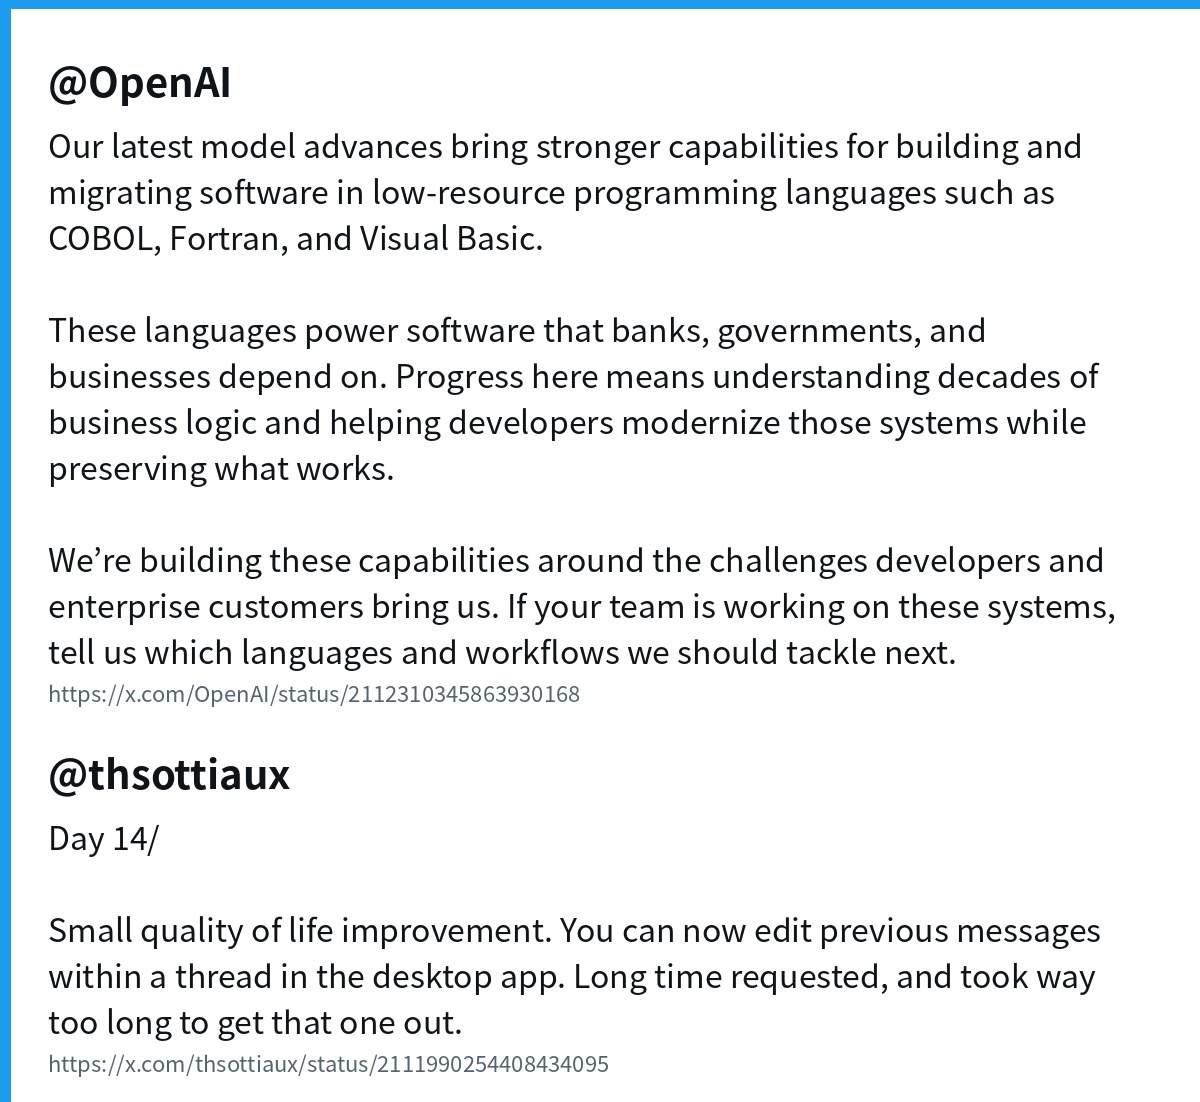
要点:@OpenAI 发文介绍新模型在 COBOL、Fortran、Visual Basic 等低资源语言上的进步。博文给了两个评测:MultiLangBench 要求模型用指定语言从零写一个兼容 SQLite 的数据库引擎,GPT-6 Astra 在 20 种语言上平均测试通过率 87.4%,GPT-5.6 Sol 只有 26.8%,COBOL 从 10.9% 升到 72.1%;GPT-6 Luna 平均 40.3%,单样本 API 成本约 $0.77(Sol 为 $3.48)。COBOL 迁移评测要求输出逐字节一致,GPT-6.1 Sol 低推理档准确率 86.6%(GPT-5.6 Sol 为 5.4%),高推理档 97.9%;评测已在 GitHub 开源。@thsottiaux 的连续发布进入第 14、15 天:Day 14 是 Codex 桌面版终于可以编辑线程里之前的消息(8.2k 赞,他说「拖得太久了」);Day 15 是一句「We're cooked」,引用 @OpenAIDevs 的「我们用 Codex 在做什么」直播。OpenCode 事件也有新进展:@thsottiaux 说 OpenAI 团队和 OpenCode 一起,让同时是 OpenAI API 客户的受影响用户恢复使用,并退回攻击期间被刷掉的额度,还建议防御方提前申请 Daybreak Blue。用户侧,@turingou 发现 Magpie 可以通过 Remote Magpie 调用另一台机器(他的 RTX 5090 游戏机)上的本地模型,并在 Codex 里直接选用;@Cydiar404 发现 Codex 的意图补全是多模态的,补全时提醒了一个他没看到的 bug。另外 @FT 报道,美国检方在 OpenAI 窃听案中指控有沙特王室关联(付费报道,仅以标题为准)。
为何值得看:银行、政府的老系统迁移是企业 coding 里最难、也最值钱的一块,OpenAI 把评测公开,意味着这块会成为模型竞争的新指标。
- OpenAI:低资源编程语言:https://x.com/OpenAI/status/2112310345863930168
- thsottiaux:Day 14,可编辑历史消息:https://x.com/thsottiaux/status/2111990254408434095
- thsottiaux:Day 15「We're cooked」:https://x.com/thsottiaux/status/2112268918681485431
- OpenAIDevs:Codex 直播:https://x.com/OpenAIDevs/status/2112242739198959913
- thsottiaux:OpenCode 用户恢复使用并退款:https://x.com/thsottiaux/status/2112034063934742720
- turingou:Remote Magpie 调用本地模型:https://x.com/turingou/status/2112204748774670665
- Cydiar404:多模态意图补全:https://x.com/Cydiar404/status/2112204180672958807
- FT:OpenAI 窃听案:https://x.com/FT/status/2112219403857039418
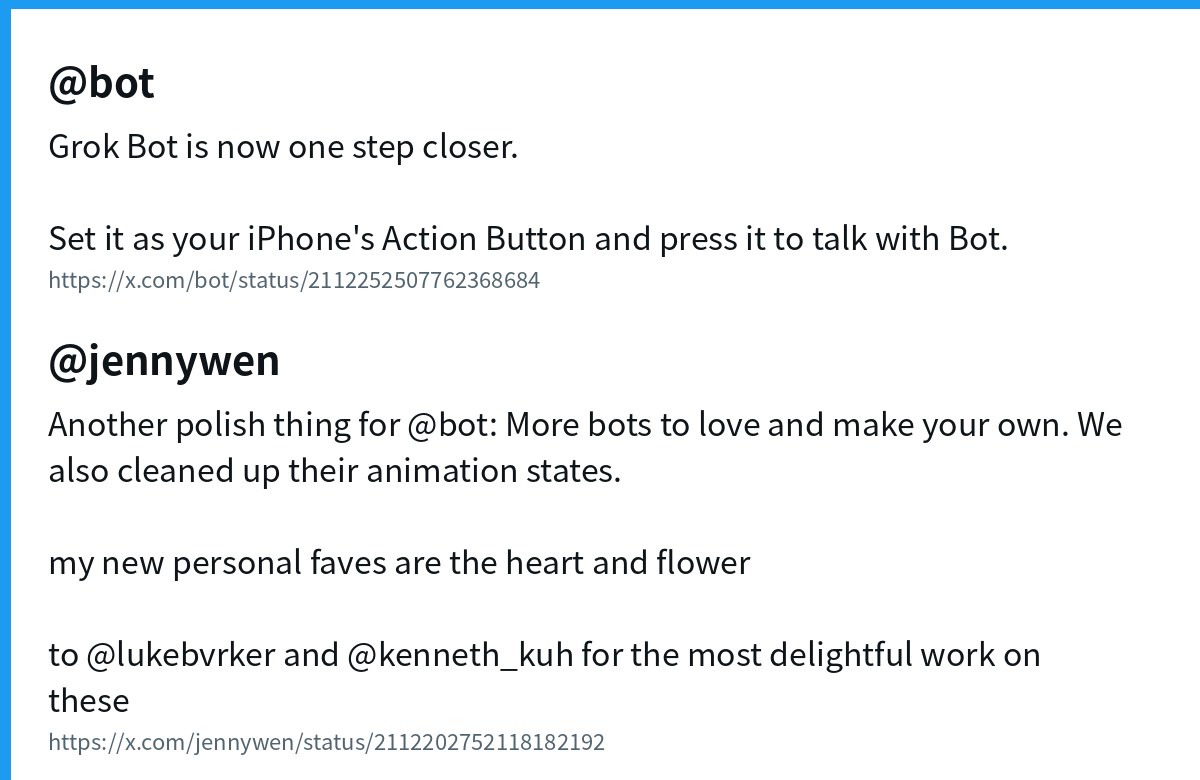
4. Grok Bot:iPhone 操作按钮一键语音,1.16 版新角色
要点:@bot 宣布可以把 Grok Bot 设为 iPhone 的操作按钮,按一下就能和 Bot 语音对话(1 万赞、68 万浏览)。@MaiYangAI 给出了设置步骤:在 iPhone 15 Pro 或更新机型上把 Grok Bot 更新到 1.16,然后在「设置 → 操作按钮」里滑到「快捷指令」,选 Grok Bot → Start Voice Chat。设计师 @jennywen 同一天发了另一项打磨:新增更多可自定义的 bot 形象,并整理了动画状态(955 赞)。用户这边,@turingou 说 Grok Bot 帮他把离岛的本地中介网站和 Instagram 信息都整合了起来,还能和其他 bot 配合,他认为几年内找房子不再需要人类中介(他个人的判断);@fankaishuoai 分享了一套自己 DIY 的「云 + 端」工作流:Grok Bot 上的 Engineer 写计划,交给云端的 Pi Agent + DeepSeek 写代码和测试,本地 Mac Studio 上的模型再做审核,以此节省套餐额度;他也夸一键聊天「开发团队很有审美」。
为何值得看:入口从 App 内挪到硬件按钮,个人 agent 正在争夺手机上最短的唤起路径;用户自己搭的云端 + 本地分工,则说明额度成本已经在影响大家怎么用 agent。
- bot:iPhone 操作按钮:https://x.com/bot/status/2112252507762368684
- MaiYangAI:1.16 设置步骤:https://x.com/MaiYangAI/status/2112308502773518667
- jennywen:更多 bot 形象:https://x.com/jennywen/status/2112202752118182192
- turingou:用 Grok Bot 找房:https://x.com/turingou/status/2112176072234037279
- fankaishuoai:云 + 端 DIY 工作流:https://x.com/fankaishuoai/status/2112211923626500585
- fankaishuoai:一键聊天「很有审美」:https://x.com/fankaishuoai/status/2112322349882323217
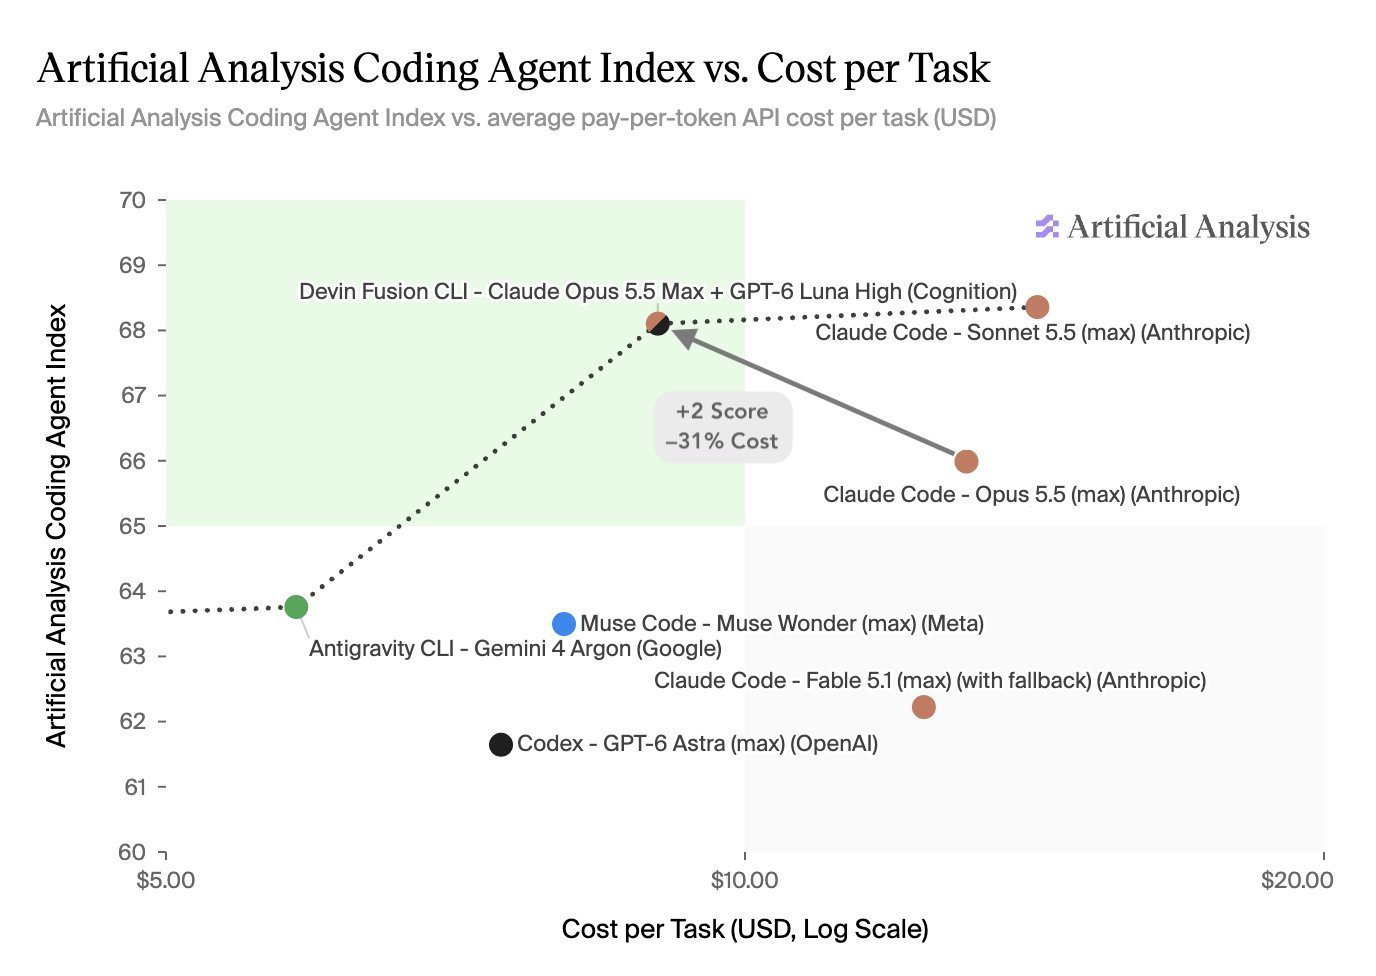
5. Cognition:Devin Fusion 拿下 Coding Agent Index 最高分,用「效率」分配额度
要点:@cognition 称 Devin Fusion(Opus 5.5 主导、GPT-6 Luna 做副手)在 @ArtificialAnlys 的 Coding Agent Index 上拿到最高分 68,表现和价格都优于 Claude Code + Opus 5.5,单任务成本低 31%(Cognition 公布的数据)。同一天 Cognition 推出新的成本控制:按会话给每位工程师打「效率分」,对高产出的工程师自动批准更多用量,而不是一刀切的额度上限;官方的说法是「一刀切的用量上限就是变相冻结招聘」。@jeffwang 补充,还会上线 Devin Coach,在跑会话之前教用户怎么用得更省;自动审批目前只在 Enterprise 计划提供。
为何值得看:多模型「主将 + 副手」组合开始在第三方榜单上胜过单一模型的 harness;而「按效率给额度」把 AI 预算变成了绩效管理的一部分,值得企业管理者关注它带来的激励问题。
- cognition:Devin Fusion 68 分:https://x.com/cognition/status/2112290148205436979
- cognition:按效率自动审批用量:https://x.com/cognition/status/2112223929414607228
- jeffwang:成本控制与 Devin Coach:https://x.com/jeffwang/status/2112229685543497745
6. Claude Code / Anthropic:多开 agent 不如慢下来,六成 Codex 用户也用 Claude Code
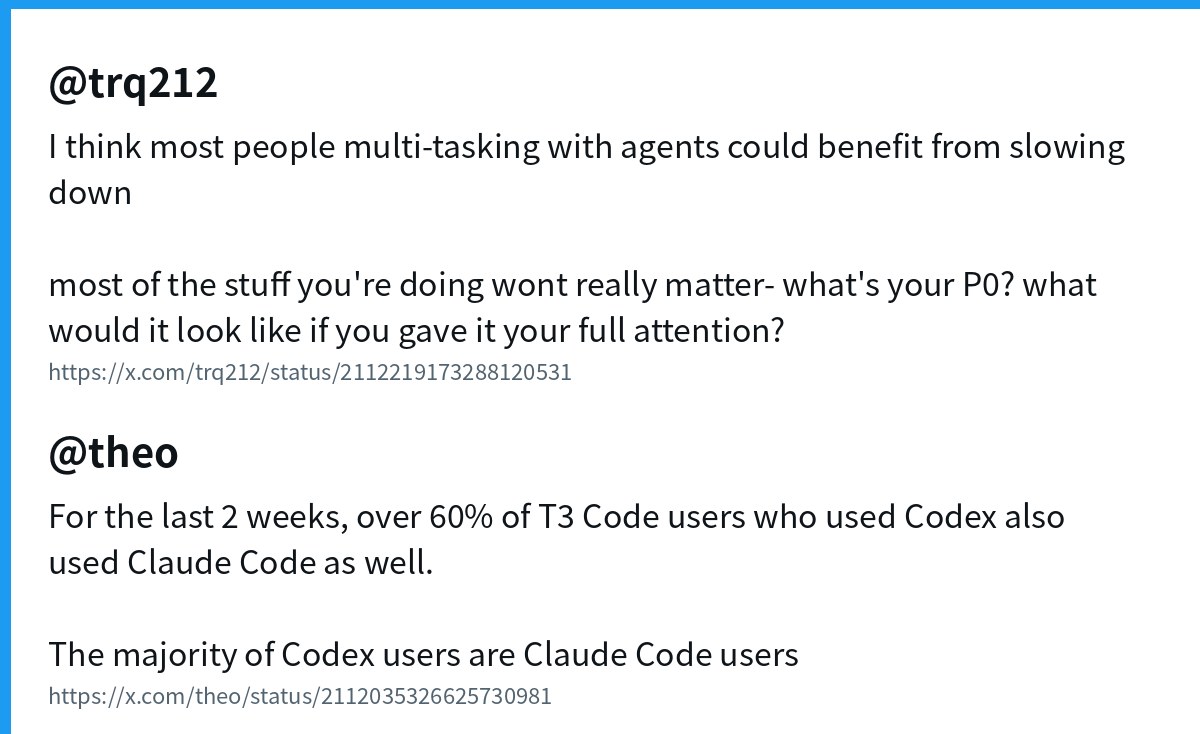
要点:Claude Code 团队的 @trq212 发帖:「大多数同时开多个 agent 的人,可能都该慢下来。你做的大部分事其实不重要,你的 P0 是什么?如果全神贯注做它会怎样?」(4.5k 赞、21 万浏览)。@theo 给出 T3 Code 的数据:过去两周,用过 Codex 的 T3 Code 用户里超过 60% 也用过 Claude Code,「大多数 Codex 用户也是 Claude Code 用户」。@LiteLLM 推荐用 LiteLLM 让 Claude Code 接其他模型。@lennysan 整理了与 Anthropic 可解释性研究员 @mlpowered 访谈的 8 条要点,包括:模型写诗时写完第一行就已选好第二行的韵脚词;模型能「说出来」的只是内部表征的一小部分(他们称之为「J space」),把其中的 Spanish 换成 French 后,模型会说文本是法语、却继续写西班牙语;以及「越往里看,越不确定它们是怎么工作的」。
为何值得看:工具在比拼「能同时开多少 agent」时,产品团队的人反而提醒注意力才是瓶颈;而跨工具的高重合度说明,用户并不忠于单一 harness。
- trq212:多开 agent 不如慢下来:https://x.com/trq212/status/2112219173288120531
- theo:六成 Codex 用户也用 Claude Code:https://x.com/theo/status/2112035326625730981
- LiteLLM:Claude Code 接任意模型:https://x.com/LiteLLM/status/2112162598603067428
- lennysan:可解释性访谈 8 条要点:https://x.com/lennysan/status/2112165116921659588
7. 跨机器跑 agent:Cua Spaces SDK,T3 Code 远程线程
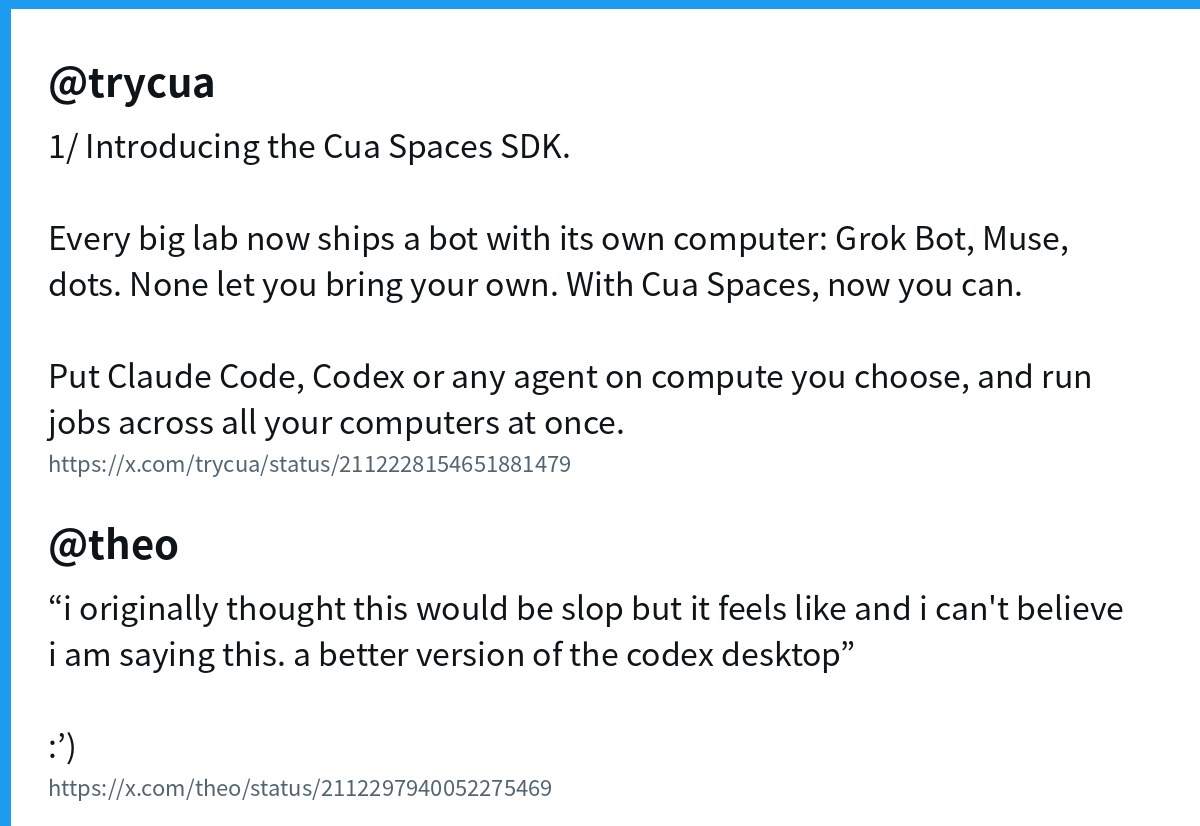
要点:@trycua 推出 Cua Spaces SDK:各大实验室都在做「自带电脑的 bot」(Grok Bot、Muse、dots),但都不能自带算力;Cua Spaces 让你把 Claude Code、Codex 或任意 agent 放到自己选的计算资源上,并在所有电脑上同时跑任务(895 赞、886 收藏)。@theo 演示 T3 Code 时说,他点开的线程大多跑在别的机器上(VPS 和本地 Linux 机器);他还引用一位用户的评价:本以为是「slop」,结果像是「更好的 Codex 桌面版」,这位用户提到扫码就能从手机开聊、子 agent 视图和 PR 流程,以及能看到成本和用量上限。
为何值得看:agent 正从「跑在你的笔记本上」变成「跑在你的一组机器上」,谁来管调度、算力和远程控制,是下一层工具的竞争点。
- trycua:Cua Spaces SDK:https://x.com/trycua/status/2112228154651881479
- theo:T3 Code 线程跑在其他机器上:https://x.com/theo/status/2111975231518867705
- theo:「更好的 Codex 桌面版」:https://x.com/theo/status/2112297940052275469
8. 开发者基础设施:Vercel 开源 libfx 与 fx0,Tessl Verifiers GA
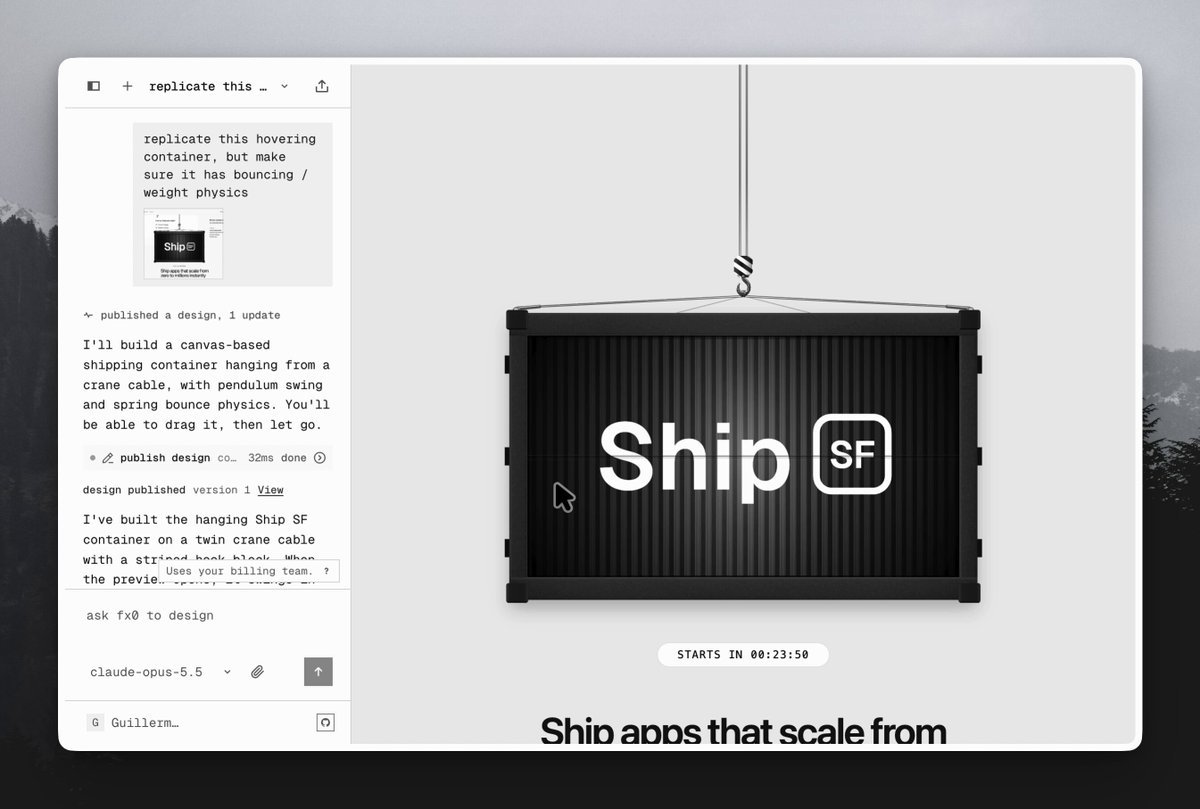
要点:@rauchg 宣布 Vercel 开源了一个「非常快」的 HTML artifact 生成器 fx0,底层是让 agent 变得「durable」的 libfx:他说为 v0 搭建能扛住服务器崩溃、LLM 不稳定、函数时限的底层管道「非常痛苦」,现在免费开源(1.1k 赞、1.1k 收藏)。@vercel_dev 介绍这是一个基于 libfx 的「mini v0」:几秒内出原型,可用 AI Gateway 的 200 多个模型,输出纯 HTML,可以 fork。@tessl_io 的 Tessl Verifiers 正式 GA:在仓库里写纯文本规则,每次 agent 改动都判定通过或失败,「给 linter 查不了的规则做 lint」。@evanyou 则抛出一个问题:把 TS 编译成原生很酷,但如果纯 TS 本身就能和原生一样快呢?
为何值得看:agent 应用要上生产,耐久执行和规则校验这类「无聊的管道」正在被开源和产品化,团队不必再自己从头造。
- rauchg:开源 fx0 / libfx:https://x.com/rauchg/status/2112247046082363821
- vercel_dev:基于 libfx 的 mini v0:https://x.com/vercel_dev/status/2112245199808434614
- tessl_io:Tessl Verifiers GA:https://x.com/tessl_io/status/2112174430004900280
- evanyou:纯 TS 能否和原生一样快:https://x.com/evanyou/status/2112303772513017960
9. Notion AI:Auto 路由便宜约 90%,支持自带模型,改用新的额度体系
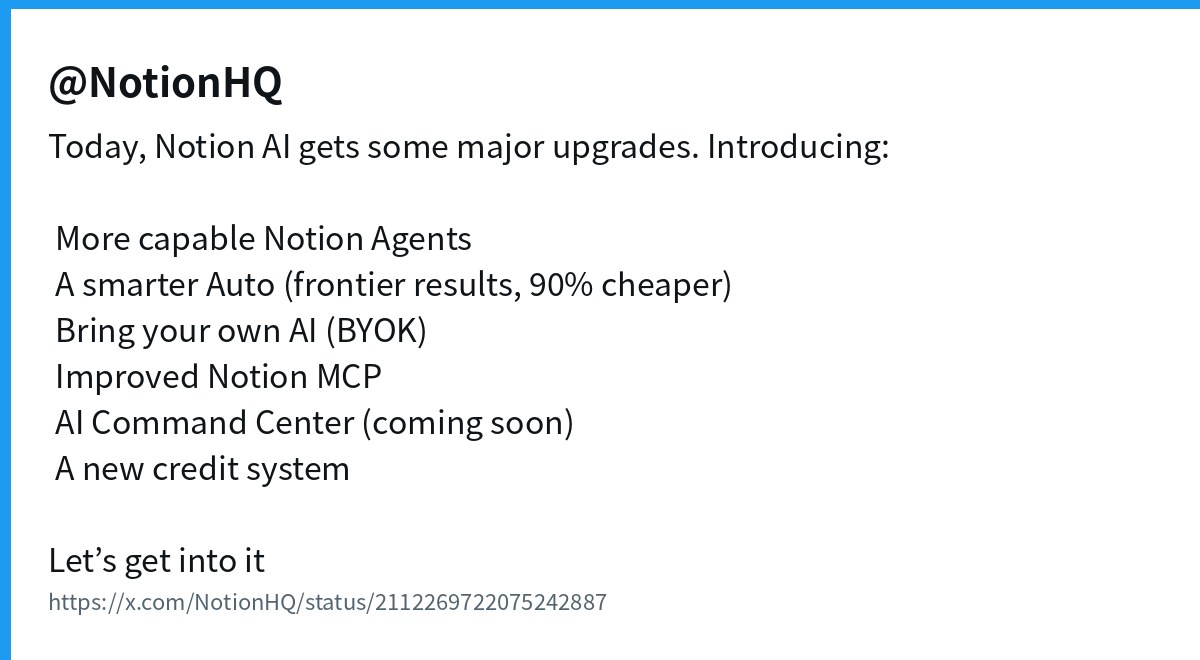
要点:@NotionHQ 宣布 Notion AI 一系列升级。按官方博文:升级后的 Auto 模型路由会按任务挑模型,在 20 多个常见用例上效果接近 Opus 5.5 和 Astra,平均成本低约 90%;Notion Agent 和 Custom Agents 换了新基础设施,可以跑更长的任务;「自带 AI」包括把 ChatGPT 套餐接入 Notion Agent(已上线)、Enterprise 自带模型 key(私有 alpha,可接 OpenAI、Anthropic、xAI)以及改进的 Notion MCP;AI Command Center 给管理员用量看板、支出上限和 agent 治理(即将推出)。新的额度体系里,Business 和 Enterprise 每个席位每月含 1,500 个 Standard 额度(Notion 选模型)和 500 个 Select 额度(自己选模型或跑 Custom Agents);新工作区 10 月 19 日起生效,现有工作区 11 月 2 日起切换。
为何值得看:「路由 + 自带 key + 分档额度」正在成为知识工作类 AI 产品的标准定价结构,用户不再直接为单一前沿模型付费。
- NotionHQ:Notion AI 升级:https://x.com/NotionHQ/status/2112269722075242887
10. Agent 应用层:Exa 3.0、Gemini 4 Argon 做 3D 赛道、Wabi 2.0 多人 agent
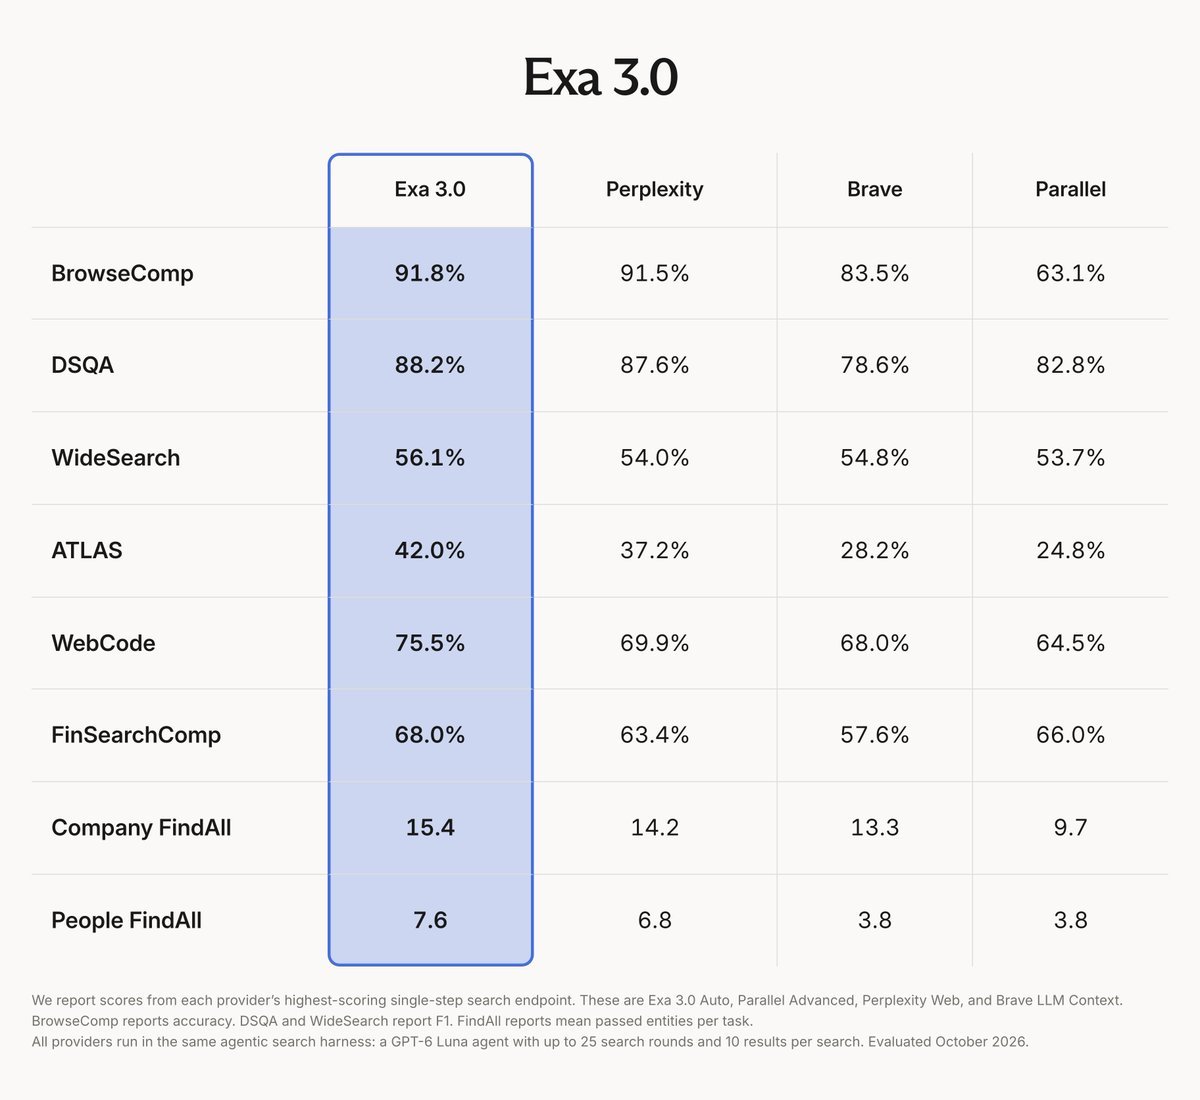
要点:@ExaAILabs 发布 Exa 3.0,称在所有测过的基准上排第一(自报)。官方博客说改进来自更大的 embedding 模型、正式开放的 Dynamic Highlights(比全文少用 95% 的 token)和扩充的索引,并新增 Exa Lite 档位,每 1,000 次请求 $4(Exa Auto 为 $7)(1.5k 赞)。@Google 展示 Gemini 4 Argon:拍一张真实书桌的照片,让 Argon 调度子 agent、Blender MCP 和 Nano Banana,把桌上的东西变成可以玩的 3D 赛道(34 万浏览)。@ekuyda 发布 Wabi 2.0,定位是「大家一起用的 agent」:家人朋友都能加入同一个对话,让它改日历、订票、排行程;@tobi 引用说「做得非常精致,你一定要试试」。
为何值得看:搜索、多模态生成和多人协作,都在被包装成 agent 的基础能力;token 效率和价格档位,已经和效果一起成为卖点。
- ExaAILabs:Exa 3.0:https://x.com/ExaAILabs/status/2112218730952601719
- Google:Gemini 4 Argon 做 3D 赛道:https://x.com/Google/status/2112199261899411579
- ekuyda:Wabi 2.0:https://x.com/ekuyda/status/2112212804979880239
- tobi:「做得非常精致」:https://x.com/tobi/status/2112263294031385028