AI Twitter 热点 · 2026-10-05
AI Twitter/X 热点 Digest · 2026-10-05(周一)
今日要点
- Codex 进入「28 天冲刺」:Tibo 宣布未来 28 天每天要么发一个对大多数用户有感的改进、要么全员 reset;同日 Theo 发长帖称 coding 模型口碑已明显倒向 Opus 5.5,OpenAI 的压力摆在台面上。
- 模型与基准:Grok 4.7 在 VulcanBench Frontier v4 与 Artificial Analysis Cyber Index 上被热转为第一;论文侧则集中在「验证器比多采样更值钱」。
- 工程方法论:pstack 0.15.9 推 /correct(把反复纠正固化成架构与检查);DHH 让 agent 把 Campfire 移植到 5 种技术栈,引出「代码不再给人读时,语言怎么选」的争论;「终端时代结束了吗」与 Karpathy 的输出形态讨论继续发酵。
1. Codex:28 天,每天一个改进或一次 reset
要点:@thsottiaux(OpenAI,ChatGPT / Codex 负责人)先发「we're locking in」:只做简化、更高效率换更多用量、突破性功能和新模型,因为反馈很明确——大家要更简单。随后升级为承诺:未来 28 天,每天要么 ship 一个对大多数 codex/work 用户明显有用的改进,要么发一次全员 reset。他还在回复里确认接下来是 6.1 Sol ultrafast(而非 Astra 6.1)。同日 Lenny 放出与 Tibo 的长访谈:model picker 可能会消失、loops/graphs 只是过渡阶段、互联网上大多数操作很快会由 agent 完成。
为何值得看:这是在 Theo 等人公开唱衰 OpenAI coding 体验的同一天给出的回应——用「每日交付 + 兜底 reset」把迭代节奏直接押在时间线上。
- 28 天承诺:https://x.com/thsottiaux/status/2106845241357824205
- Locking in:https://x.com/thsottiaux/status/2106610099720720811
- 6.1 Sol ultrafast:https://x.com/thsottiaux/status/2106607456130592861
- Lenny 访谈:https://x.com/lennysan/status/2106772428861149683
- DevDay 只是第一天:https://x.com/romainhuet/status/2106868228840665329
2. Opus 5.5 vs GPT:Theo 的「口碑反转」长帖
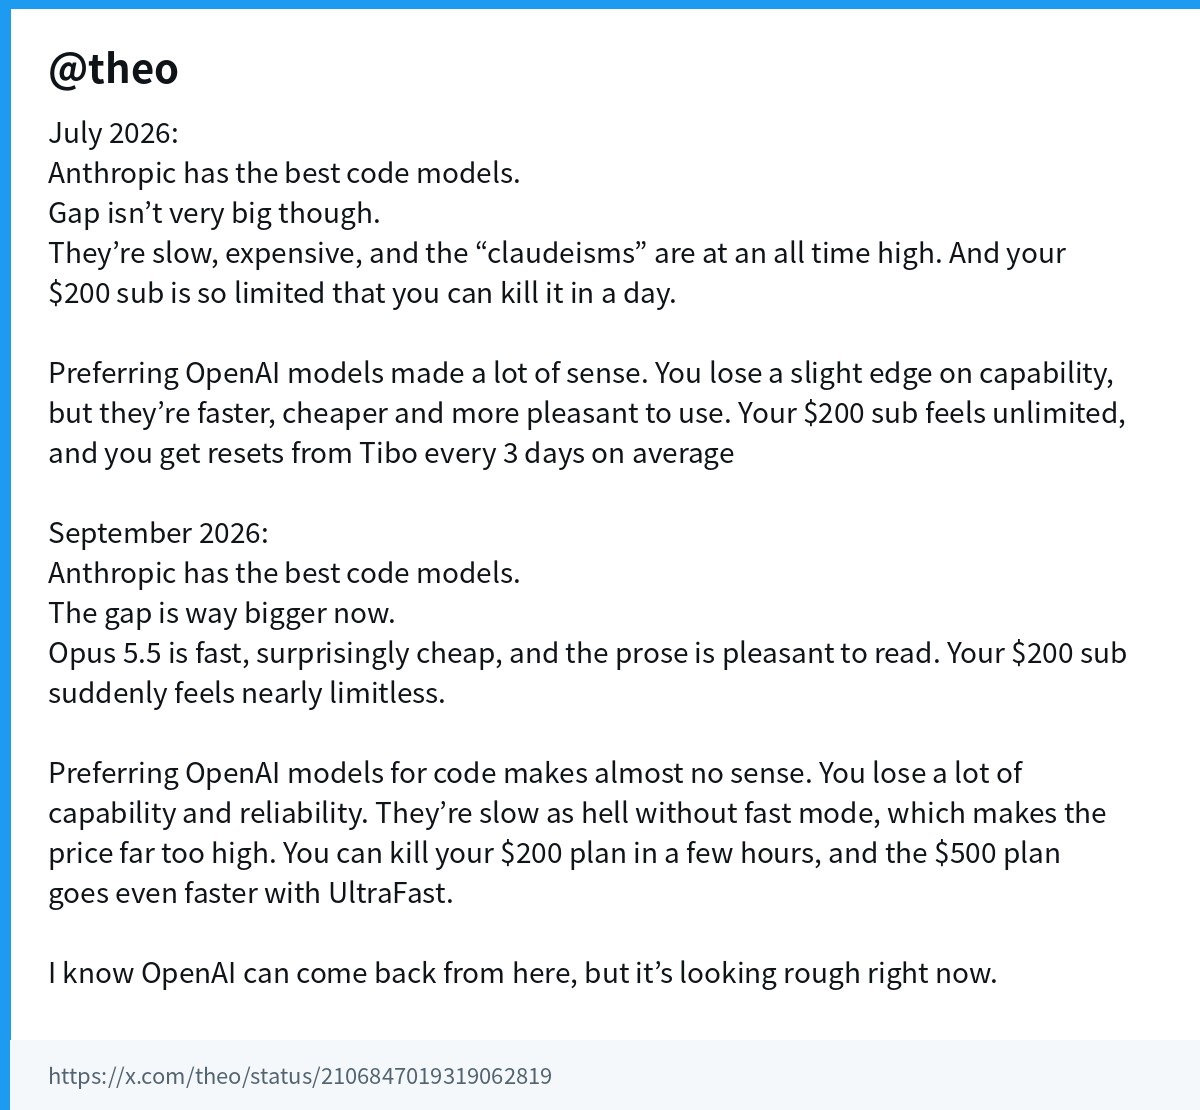
要点:@theo 对比两个时间点——7 月:Anthropic 代码模型最强但差距不大,慢、贵、「claudeisms」多、$200 订阅一天就能用完,选 OpenAI 很合理;9 月:差距明显拉大,Opus 5.5 快、意外便宜、文字也好读,$200 订阅几乎用不完;反观 OpenAI 模型不开 fast mode 很慢,$200 计划几小时就烧完,$500 档配 UltraFast 烧得更快。他还给出「vibe 打分」:Opus 5.5 代码 9 / 可读性 8.5 / 价格 8 / 理解意图 9,GPT-6 Astra 代码 7.5 但理解意图只有 3。中文圈同步调侃:Tibo 问「Codex 还缺什么」,点赞最高的回复是「Opus 5.5」。
为何值得看:头部独立开发者的模型偏好会直接影响 harness 默认选项与订阅流向;这也解释了第 1 条 Codex 为何急着「锁定」。
- 7 月 vs 9 月:https://x.com/theo/status/2106847019319062819
- Vibe 打分:https://x.com/theo/status/2106847949963800615
- 「缺的是 Opus 5.5」:https://x.com/tualatrix/status/2106560368126673226
3. Grok 4.7:Frontier v4 与 Cyber Index 双榜第一
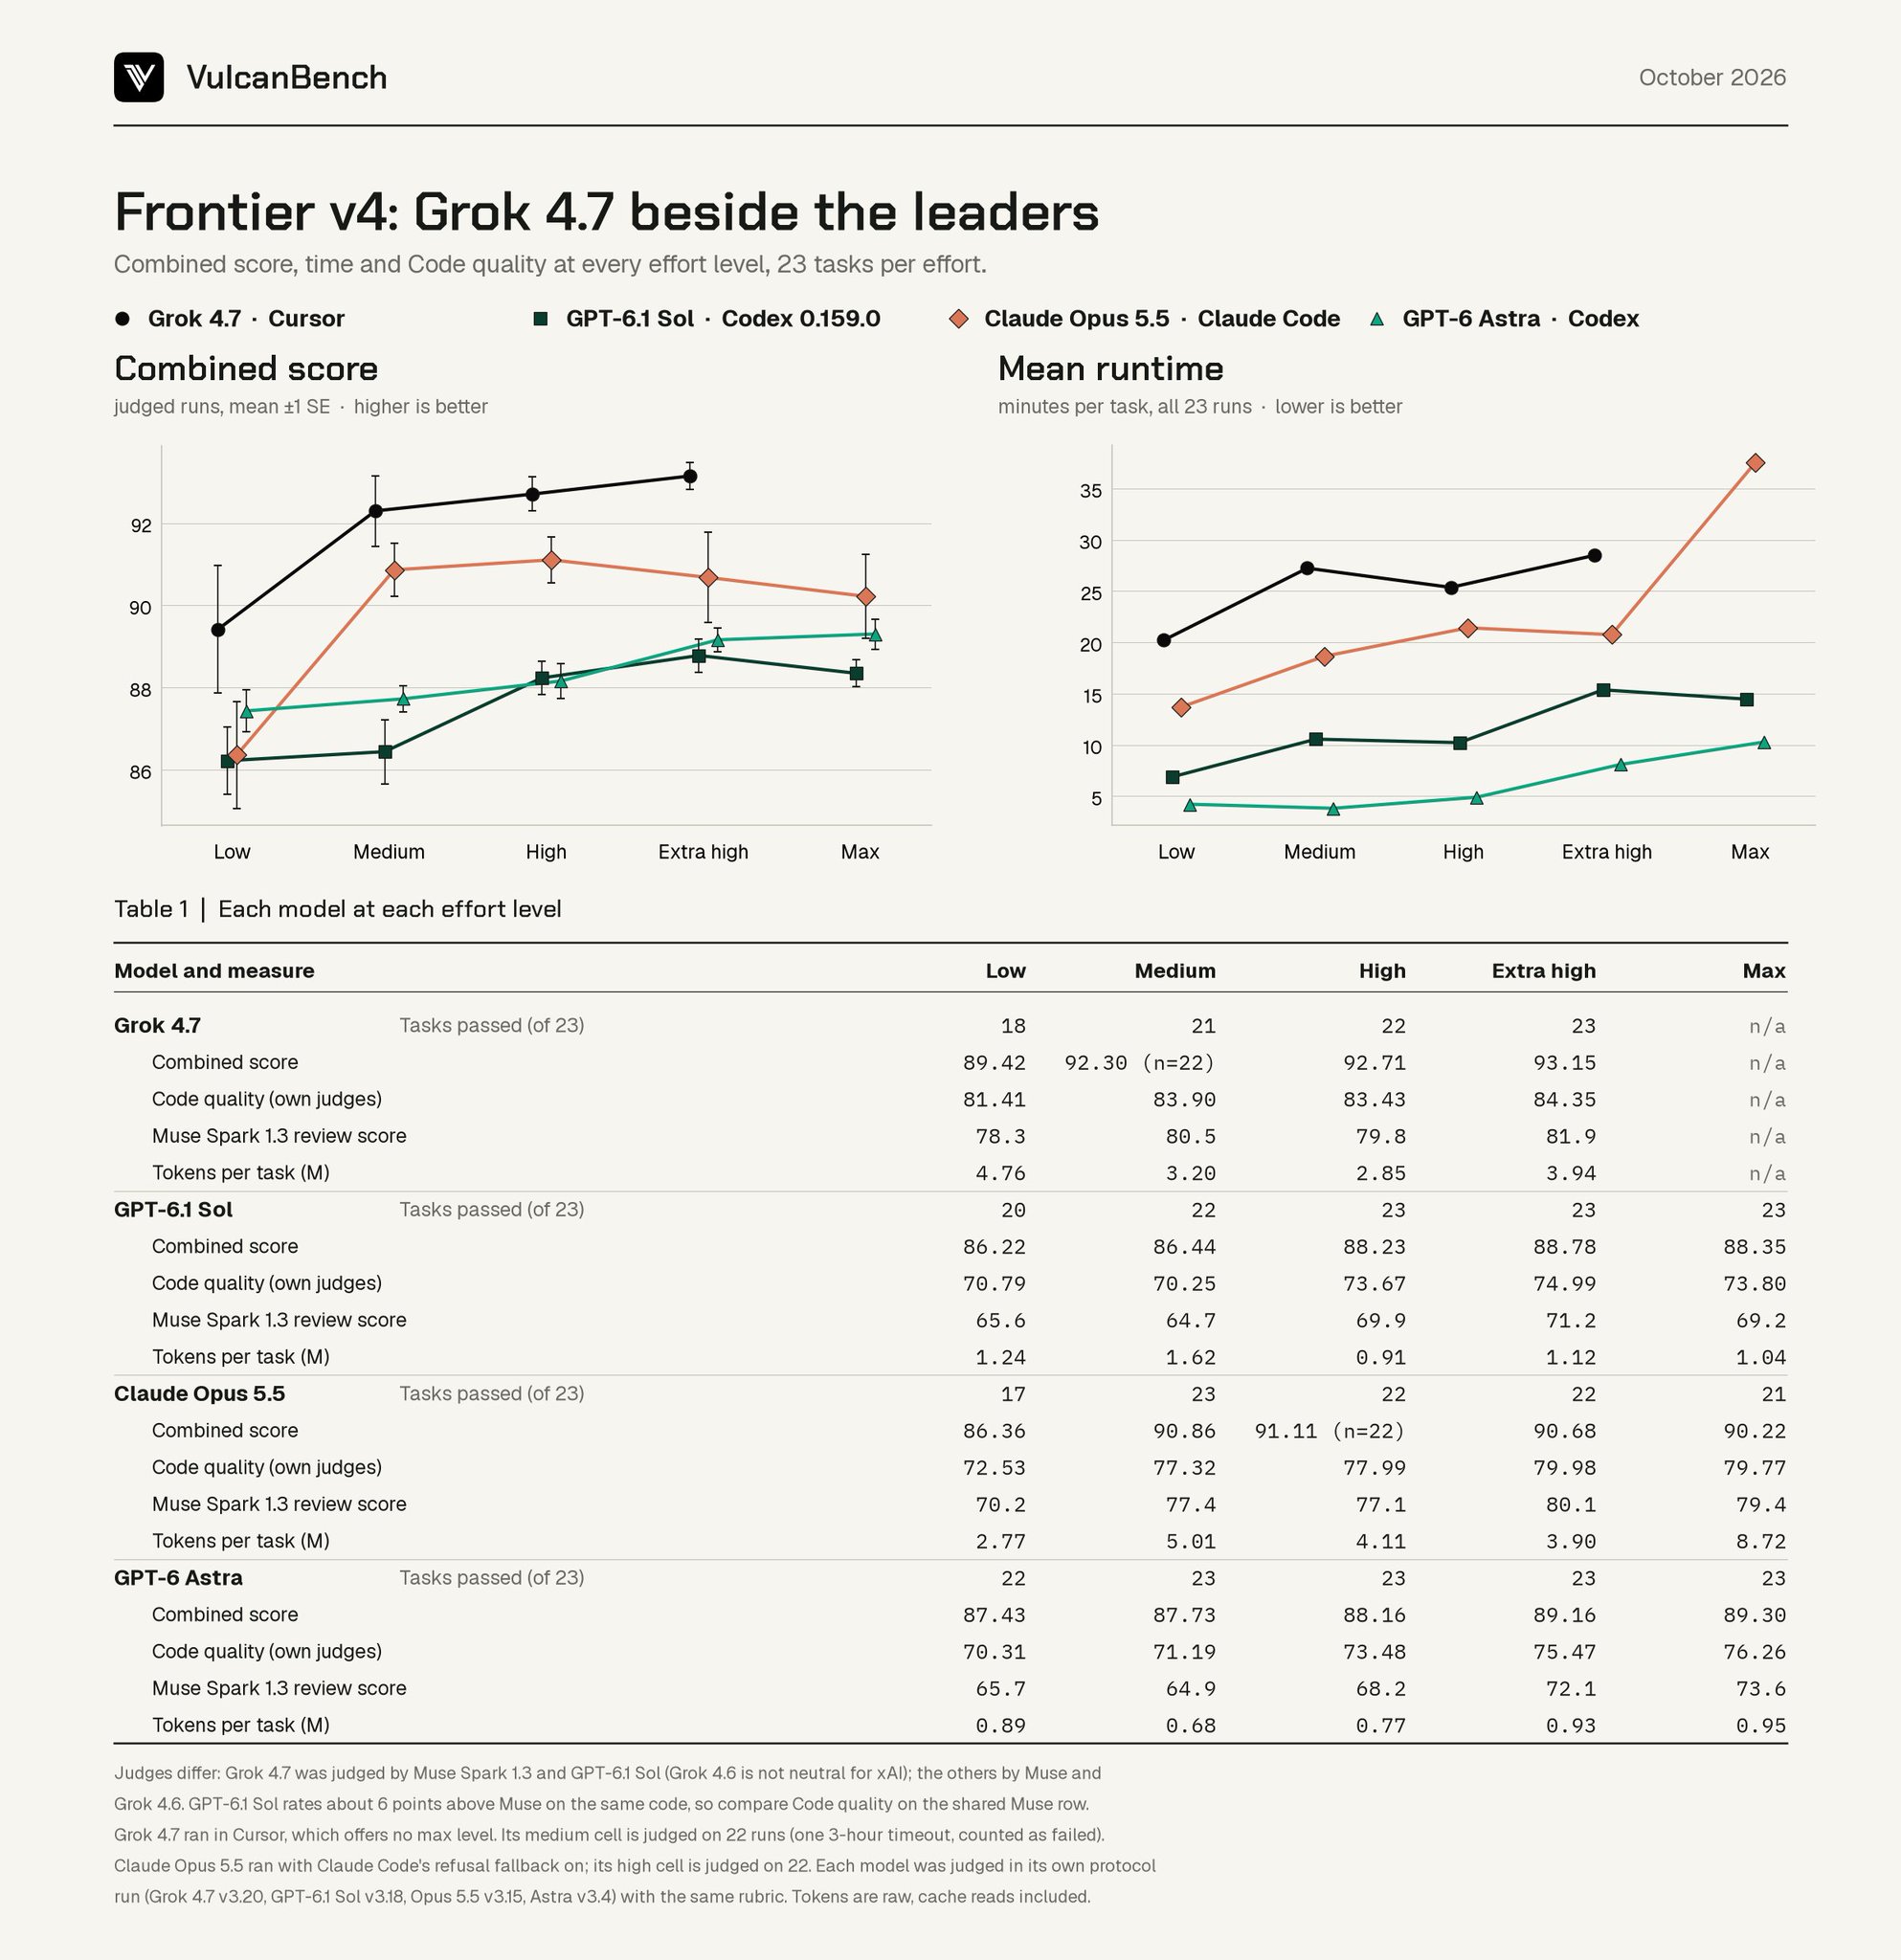
要点:@morganlinton 转述 VulcanBench Frontier v4:Grok 4.7 在各 effort 档的综合分都高于 GPT-6.1 Sol、Opus 5.5、GPT-6 Astra(被 Elon 转发)。另一条热传称 Grok 4.7 xHigh 位列 Artificial Analysis Cyber Index 第一(由 CWE-Bench-AA、DeepsecBench-AA、CyberGym-E2E-AA 组成)。需要注意的是,Frontier v4 图表脚注写明:Grok 4.7 跑在 Cursor 里且没有 max 档,评审模型也与其他选手不同(Muse Spark 1.3 + GPT-6.1 Sol),而且它平均耗时最长。
为何值得看:榜单是今天模型话题的最大流量入口,但跨 harness、跨评审的比较口径差异很大,看分数之前先看脚注。
- Frontier v4:https://x.com/morganlinton/status/2106737322255622550
- Cyber Index:https://x.com/XFreeze/status/2106773576258851087
- Elon 转述:https://x.com/elonmusk/status/2106787000682426513
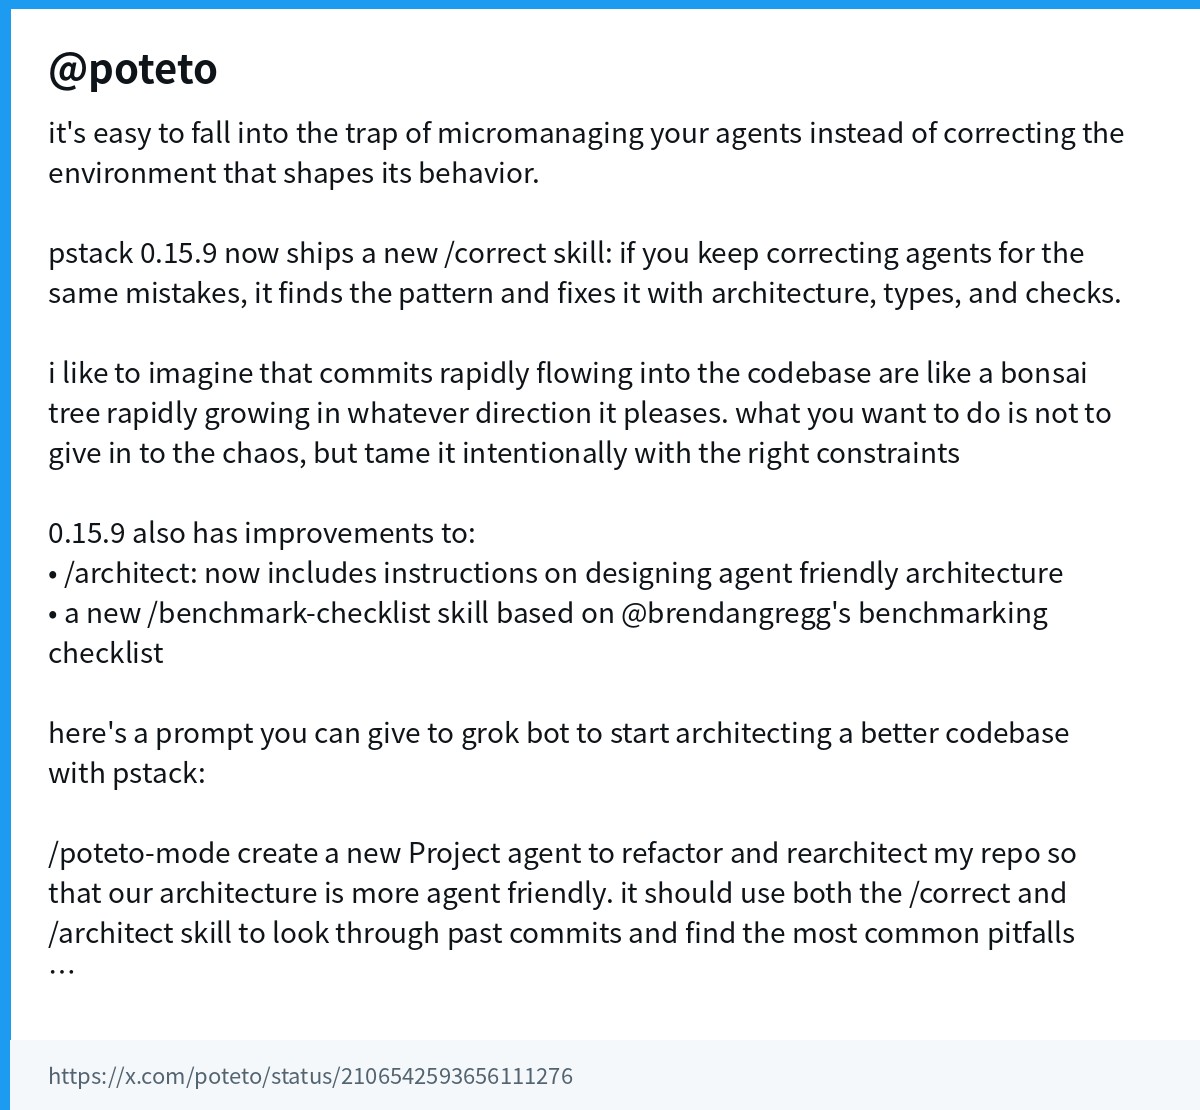
4. pstack 0.15.9:别微操 agent,去改「环境」
要点:@poteto 发布 pstack 0.15.9:新增 /correct skill——如果你总在为同一类错误纠正 agent,它会找出模式,并用架构、类型和检查把问题从根上消除;/architect 加入「agent 友好架构」设计说明;新增基于 Brendan Gregg 方法的 /benchmark-checklist。同日 @dotey 长文整理 Lauren Tan(@poteto)与 Matt Pocock 的访谈:她一个月合并约 2500 个 PR 却不逐个 review,靠的是「验证 skill + 代码规矩 + 夜间自动检查合并、早上抽查回滚」,而且 2500 个 PR 里多数是维护性工作。
为何值得看:把「人工纠错」转化为 lint、类型和架构约束,是规模化 agent 产出时最可复制的一条经验。
- pstack 0.15.9:https://x.com/poteto/status/2106542593656111276
- 访谈长文解读:https://x.com/dotey/status/2106635352609865925
- 演讲与 Q&A:https://x.com/poteto/status/2106893179605876927
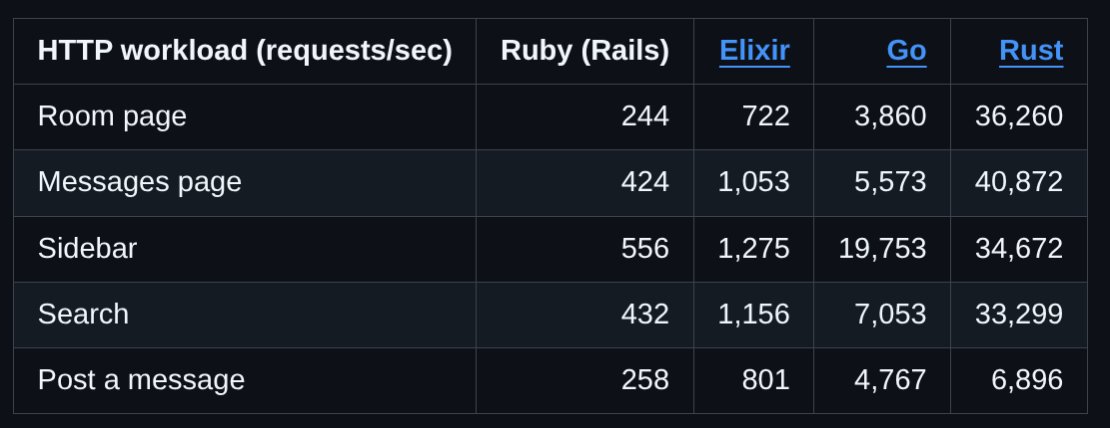
5. DHH:AI shed + 让 agent 把 Campfire 移植到五种技术栈
要点:@dhh 主张每个开发者都需要一个「AI shed」:一台常开、挂在 tailscale 网络上的机器,大部分 agent 都跑在上面。他还让 agent 把 Campfire 分别用 Elixir、Go、Rust 实现并优化,后来又补上了 Laravel 和 Django 版本:在 HTTP 吞吐上 Rust 远超 Rails,但 Rust 版代码量是 Rails 的 10 倍以上。他的问题是:「如果你已经不读代码了呢?」@rauchg 回应称 Vercel 当年把 Turborepo 从 Go 迁到 Rust 时,ROI 在内部争议很大,因为写代码的是人;现在这笔账已经变了。
为何值得看:当代码主要由 agent 编写、由 agent 阅读,「对人友好」和「对业务最优」开始分家,语言与框架的选型逻辑随之改变。
- AI shed:https://x.com/dhh/status/2106755814421565495
- Campfire 三语言:https://x.com/dhh/status/2106810173683851564
- Laravel / Django 版:https://x.com/dhh/status/2106872067039838324
- Rauch 回应:https://x.com/rauchg/status/2106863842450133114
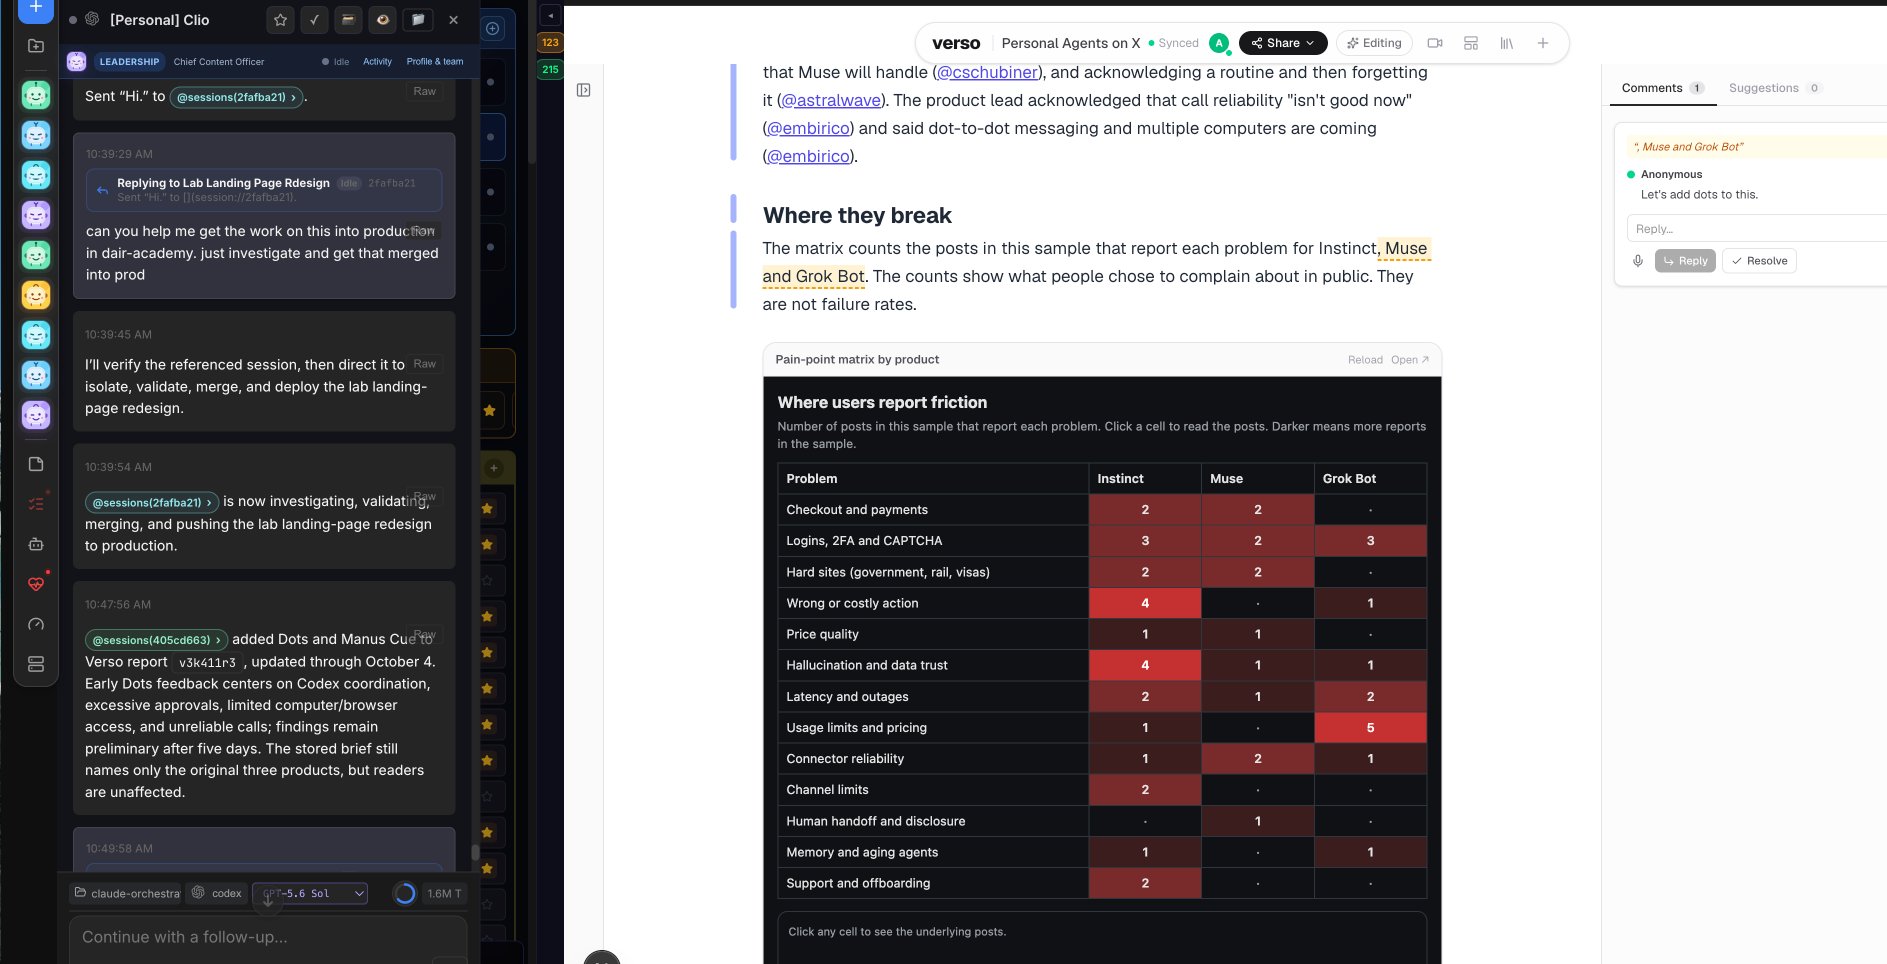
6. Agent 界面之争:终端时代结束了?输出该长什么样?
要点:前一天「终端是 coding agent 的错误界面、Codex 桌面版是目前最好的 agentic UI」的观点继续发酵:@omarsar0 称直接用 CLI 跟 agent 交互早就过时,CLI 只在后台跑,前台是常驻 agent 管理多个专用会话;@jerryjliu0 认同 ChatGPT/Codex 是深度工作的最佳界面(统一且支持 forking),但认为 Claude Code CLI 已经是 CLI 能做到的极致;中文圈有人推荐多 agent 图形界面 Paseo。另一条线是 Karpathy 关于「如何读懂 LLM 输出」的帖子(建议用 HTML、图示、解说视频)收获 5 万赞后,omarsar0 展示了自己的「通用界面」:类 Notion 页面嵌入 artifacts、可视化解释,人与 agent 通过评论协作;Karpathy 回应称,99% 以上正在关注 AI 的人入场不到一年。
为何值得看:coding agent 的主战场正从「哪个 CLI 更好用」转向「人怎么高效审阅与指挥大量 agent 输出」。
- CLI 已死:https://x.com/omarsar0/status/2106594883590910345
- Codex 界面 vs Claude Code CLI:https://x.com/jerryjliu0/status/2106844101635379533
- Paseo 多 Agent GUI:https://x.com/fankaishuoai/status/2106712940388991225
- 通用界面:https://x.com/omarsar0/status/2106801689495826520
- Karpathy 回应:https://x.com/karpathy/status/2106806571321966793
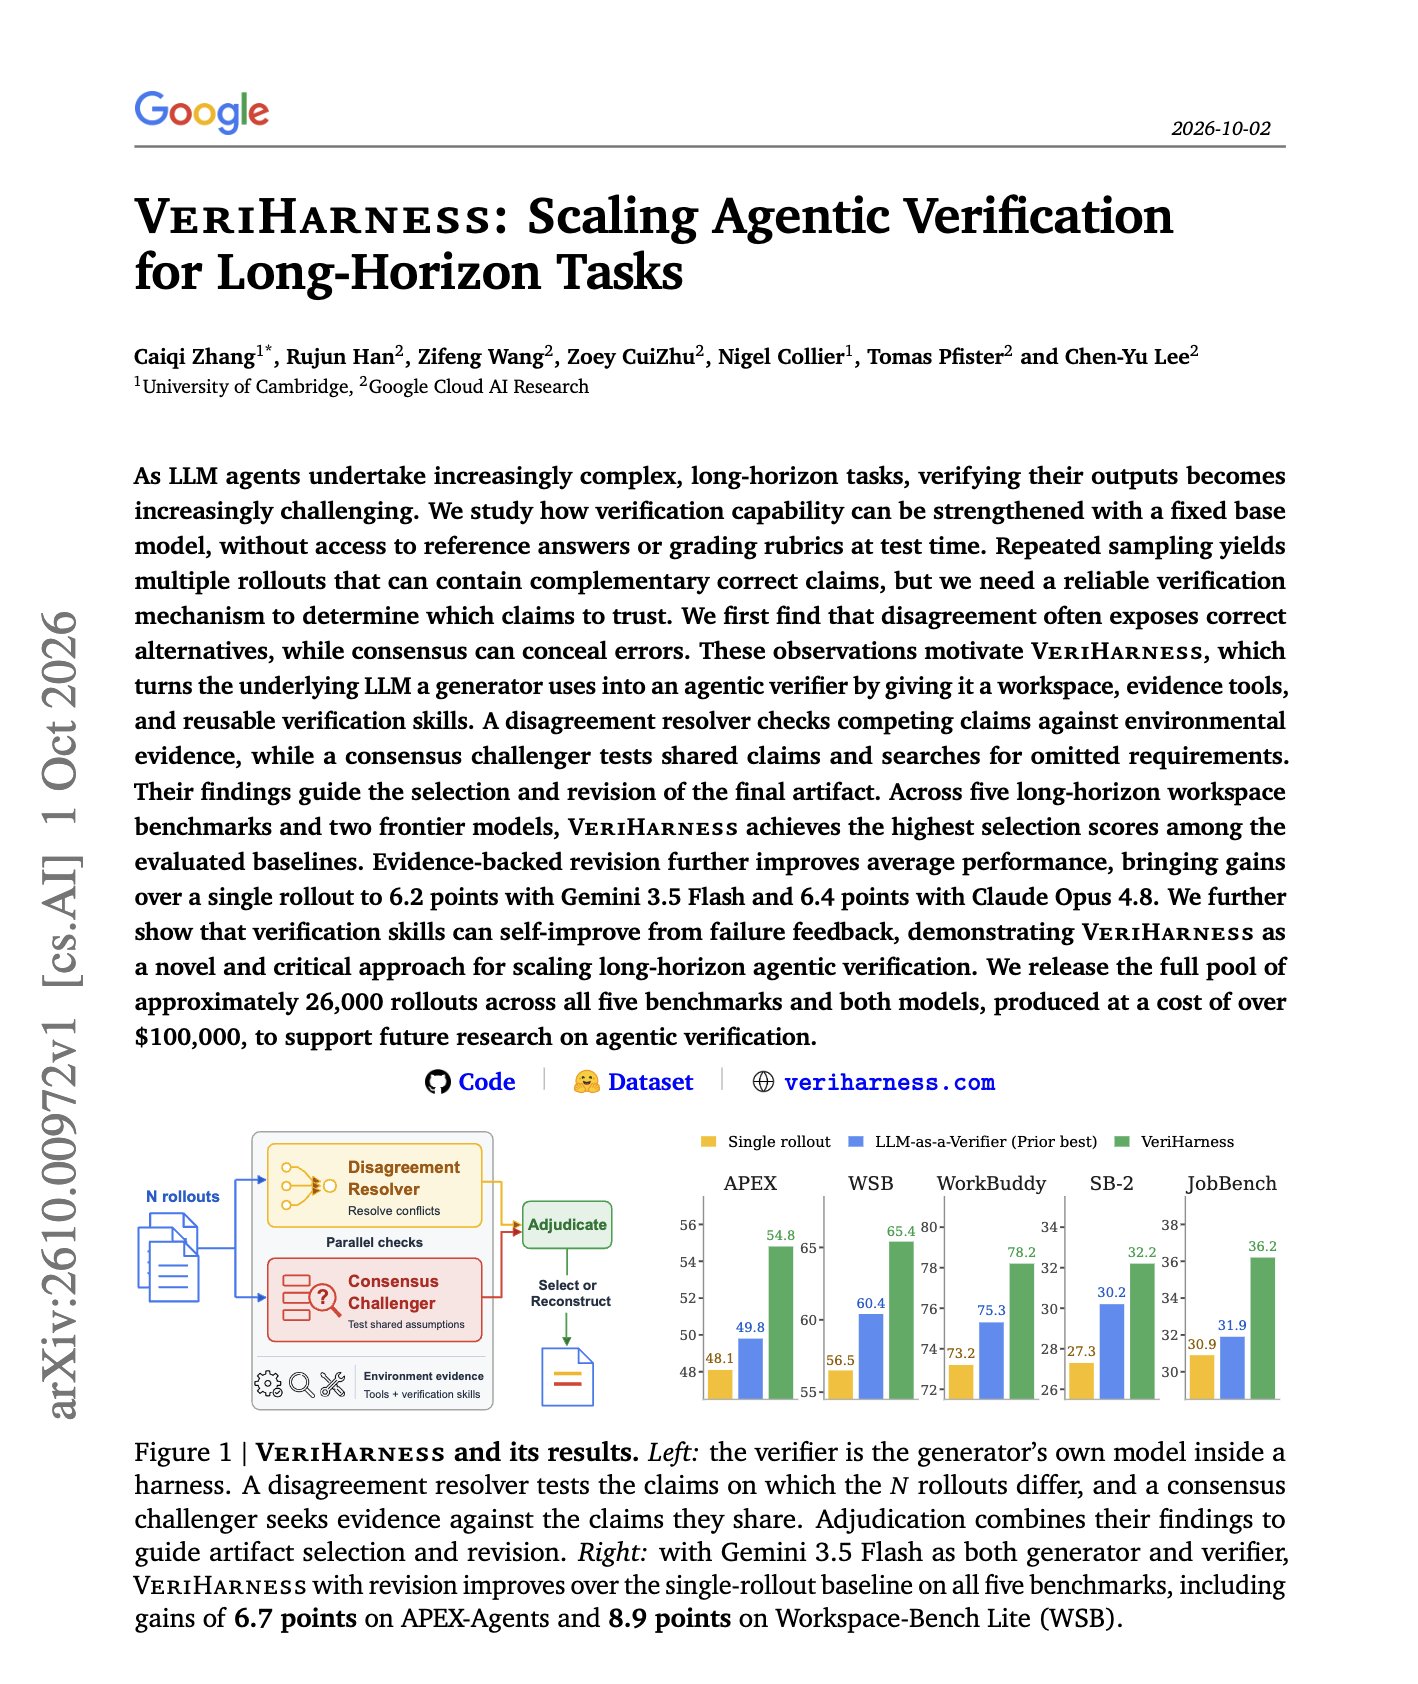
7. 论文周报:验证器 > 多采样,harness 也能「进化」
要点:@omarsar0 / @dair_ai 集中推了三篇 harness 相关论文。Google VeriHarness:多条 rollout「一致」可能掩盖共同错误,于是让同一基座模型充当验证器,对分歧点查工作区证据、对共识点主动找遗漏,在 5 个长程基准上选择效果最好。NVIDIA Mid-Harness:终端 agent 应先采样多条 shell 命令、验证后再执行,算力花在验证器上比多采样更值,用 GPT-5.6 Sol 当验证器后 TerminalBench-Lite Pass@1 从 50% 提升到 68%。Microsoft ScholarEvolve:依据已发表的研究(而非失败日志)进化 harness 模块,在模型固定的前提下 AppWorld 和 Tau2 均有明显提升。
为何值得看:继「把 harness 训进模型」之后,研究焦点转向验证器与 harness 本身的自动改进——对自建 agent 的团队可以直接借鉴。
- VeriHarness:https://x.com/omarsar0/status/2106700905051746803
- Mid-Harness:https://x.com/dair_ai/status/2106700907106943107
- ScholarEvolve:https://x.com/omarsar0/status/2106619582463312315
8. LangChain:coding agent 成本连续两个月下降
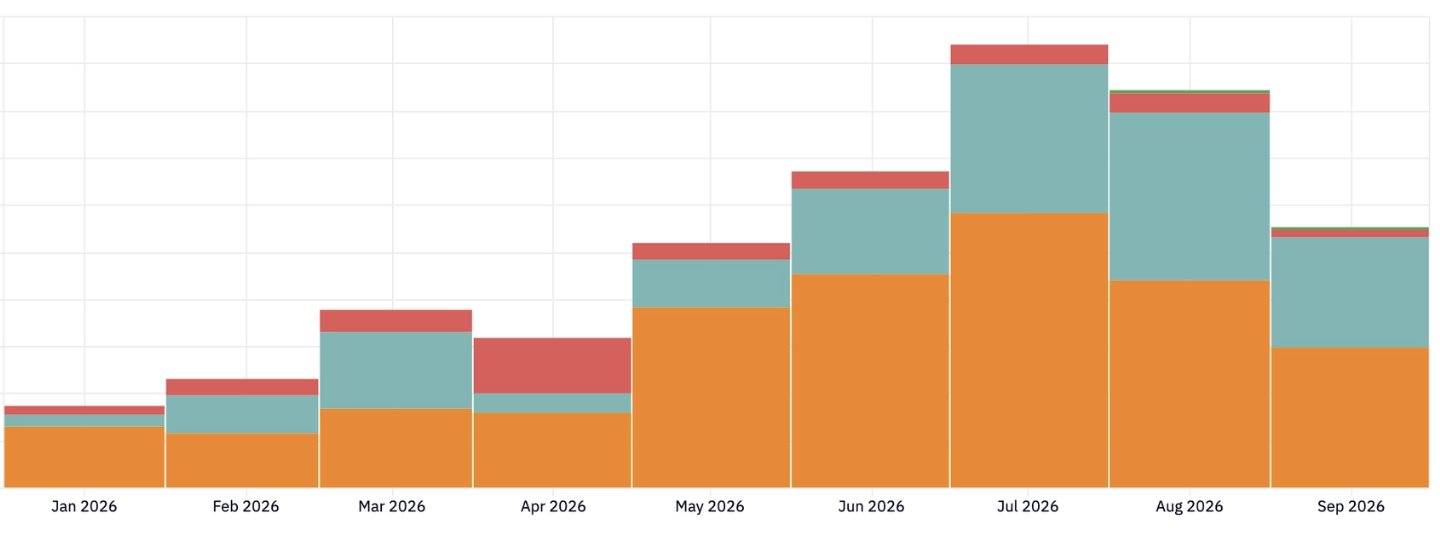
要点:@hwchase17 透露 LangChain 内部 coding agent 花费连续第二个月显著下降,并给出三步:① 成本可见:全部用量追踪进 LangSmith,已对接主流 coding harness;② 成本控制:在 LLM gateway 上设置用户级额度上限(要提额得找 VPE);③ 优化 harness:更多工作迁到自家开源云端 agent harness OpenSWE,借助模型路由等手段降本。
为何值得看:从图表看,用量在 7 月见顶后回落——agent 花费正从「随便用」进入有治理的阶段,这三步具有通用性。
9. Cline:因滥用暂停免费 DeepSeek-V4.1-Flash
要点:@cline 宣布,由于出现异常严重的滥用,暂停免费 DeepSeek-V4.1-Flash 推广,目前正在调查与缓解。此前几天 Cline 正以免费开源权重模型配合 Desktop 新功能拉新。
为何值得看:「免费 frontier 开源模型」是 coding IDE 的常用获客手段,但被薅之后能否持续,是这类活动的现实约束。
10. Vitalik:本地 Qwen 3.8 Flash Next 编排,远程 frontier 只当工具
要点:@VitalikButerin 做了个隐私实验:用健康与出行数据生成个性化饮食和运动建议,由本地 Qwen 3.8 Flash Next 负责编排,远程 frontier 模型只作为 tool call 调用。三层隐私:由本地模型代写查询(避免 PII 与文风泄露)、用 zkAPI 隐藏支付身份、用 Tor 隐藏网络身份;再用一个 skill 文件教本地模型如何构造最少暴露数据的请求。不足之处:Tor 不适合逐请求去关联;本地模型 20–30 TPS 仍然偏慢(要 100+ 才算快);给得越少,远程模型能帮的也越少。
为何值得看:中国开源小模型在「本地编排 + 云端大模型当工具」的架构里担任主控,这是隐私敏感场景的一种可落地范式。