AI Twitter 热点 · 2026-09-28
AI Twitter/X 热点 Digest · 2026-09-28(周一)
今日要点
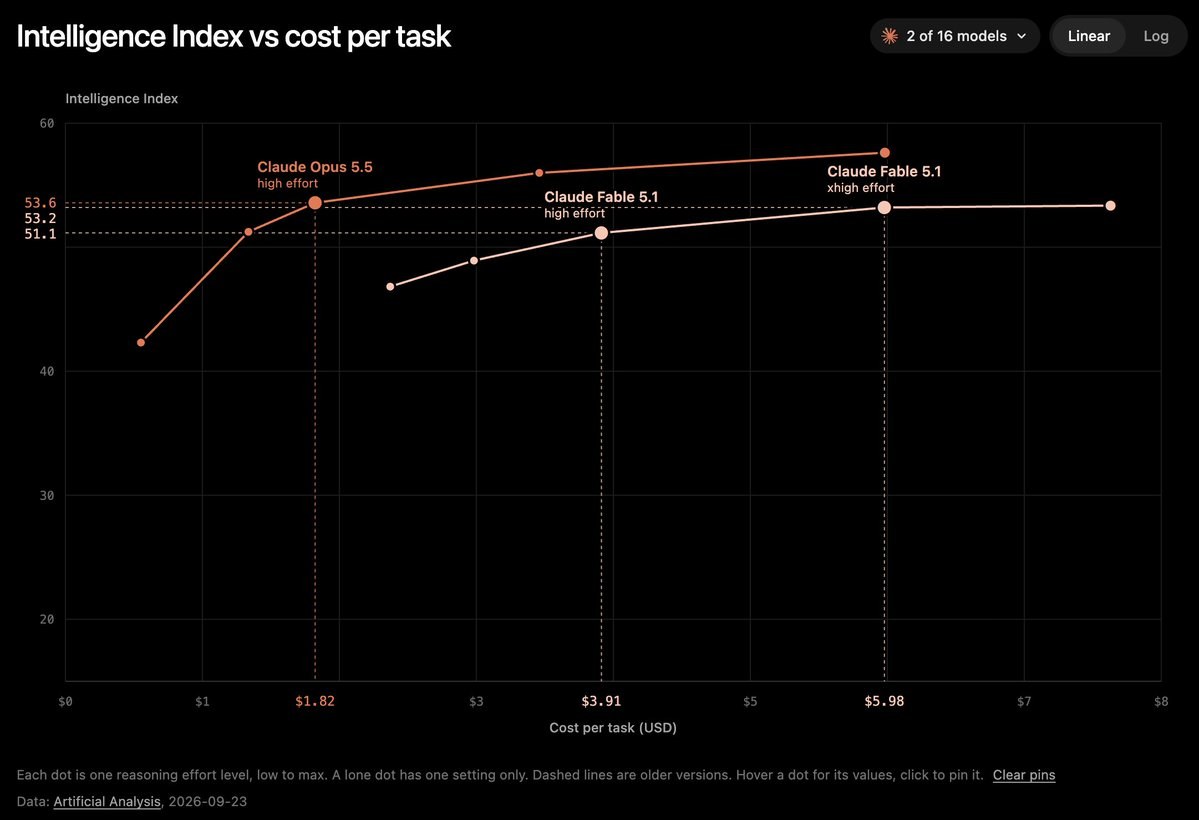
- Opus 5.5 继续刷屏:从「魔法」体感到刷爆 Max 配额,再到相对 Fable 5.1 约 4–6× 的限额体感;另有人用 OpenClaw 跑 Opus,觉得任务完成度压过 GPT-6 Astra。
- antirez 谈 Astra 需要新技能集;Codex 被拿去裁 CI;UFO 多智能体 harness OS 宣布上线。
- Cline 上架 Ember-1(基于 Kimi K3,约少 40% tokens);GitHub Copilot 强调并行 agents;另有 DeepSeek Harness 插件、Jev-as-a-Judge,以及 Claude 封禁后转向 OpenCode + DeepSeek 的讨论。
1. Opus 5.5:从「魔法」到刷爆 Max 配额
要点:@dhh 直接写「Anthropic did magic with Opus 5.5」。@theo 则说过去 5 天差不多「杀掉」约 3.5 个 $200 Claude Code 账号——Opus 5.5 很猛,Max 订阅「太划算」。同日他还拆了限额体感:Opus 更省、Fable 还有 50% 上限,从 Fable 5.1 High 换到 Opus 5.5 High 大约是 4.3× 限额提升,从 Fable xhigh 换过去约 6.6×。@AravSrinivas 把原 Fable 5.1 编排的 50–100 个工作流迁到 Opus 后差异不大,但仍有不用「更聪明模型」的 FOMO。
为何值得看:讨论焦点已从「谁更聪明」转到「单位配额能扛多久、编排层换模型有没有断层」。
- dhh:https://x.com/dhh/status/2104273594217812283
- Theo 刷爆 Max:https://x.com/theo/status/2104079585956761814
- 限额对比:https://x.com/theo/status/2104339496942948401
- 工作流对比:https://x.com/AravSrinivas/status/2104270322757509315
2. Opus 5.5 × OpenClaw:任务完成度压过 Astra?
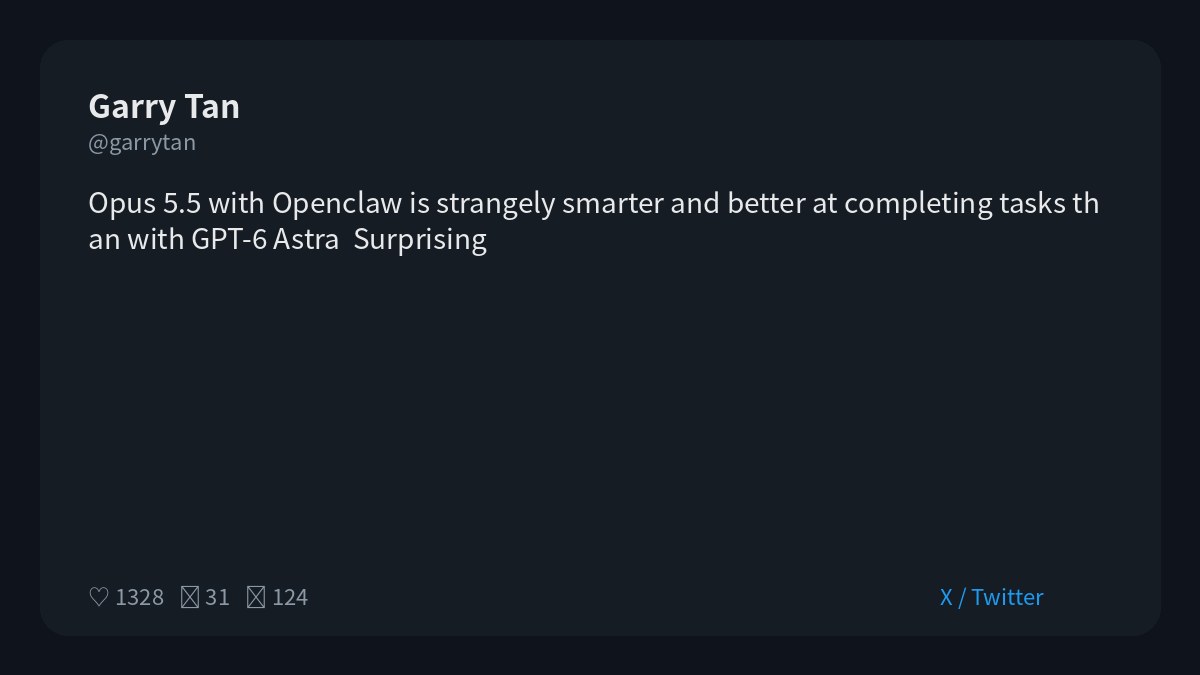
要点:@garrytan 称 Opus 5.5 配 OpenClaw「奇怪地更聪明、更能把任务做完」,表现好过 GPT-6 Astra,并表示惊讶。这把「模型 × harness」组合又推回台前。
为何值得看:同一天社区一边吹 Opus 配额效率,一边把它放进具体 agent 运行时里比完成率——默认栈可能同时换模型与壳。
3. antirez:用不好 GPT-6 Astra,可能是技能集过时了
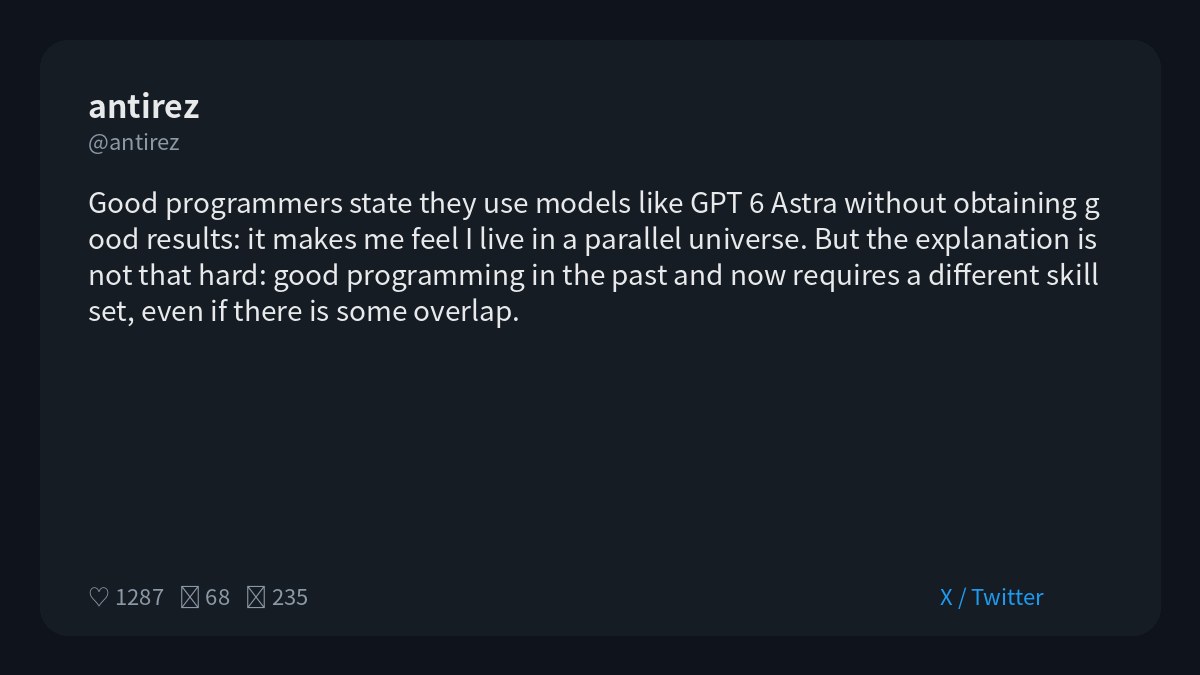
要点:@antirez 观察到「好程序员」说自己用 GPT-6 Astra 却拿不到好结果;他认为解释并不玄——过去的好编程与现在所需技能集已不同,虽有重叠但不再等价。
为何值得看:把「模型不行」重新框成「人机协作技能迁移」,和配额/壳层讨论形成互补。
4. Codex:让模型决定跑哪些 CI 测试
要点:面对「CI 已成为工程团队最大瓶颈」的讨论,@steipete 说赞助方 @useblacksmith 很好,但仍要分摊负载;他的计划是让 Codex 决定哪些测试真正需要跑,大幅砍掉 CI,改为按小时跑测。另有中文圈转述 Codex app 负责人 @ajambrosino:新模型一出来就让它在 GPUI + Rust 里重写 Codex app。
为何值得看:coding agent 从「写代码」延伸到「决定测什么」——CI 成本本身成了 agent 产品面。
- steipete:https://x.com/steipete/status/2104305554760114488
- GPUI/Rust 提示:https://x.com/huacnlee/status/2104157032546983946
5. UFO:多智能体 orchestrator / memory 系统上线
要点:GitHub Copilot 共同创造者 @alexgraveley 宣布 UFO 上线——面向 agent-first 业务痛点的可扩展多智能体编排与记忆系统;官方账号称它是可承载整家公司的 multiplayer agent harness OS,支持托管或开源,擅长代码与工作流。站点为 ufo.ai。这是产品公开上线叙事,不宜写成「今天才第一次开源」。
为何值得看:又一个从大厂 agent 经验里长出来的独立 harness,叙事直接对准「公司操作系统」而不只是 IDE 插件。
6. Cline:Ember-1(Kimi K3 后训练,约少 40% tokens)
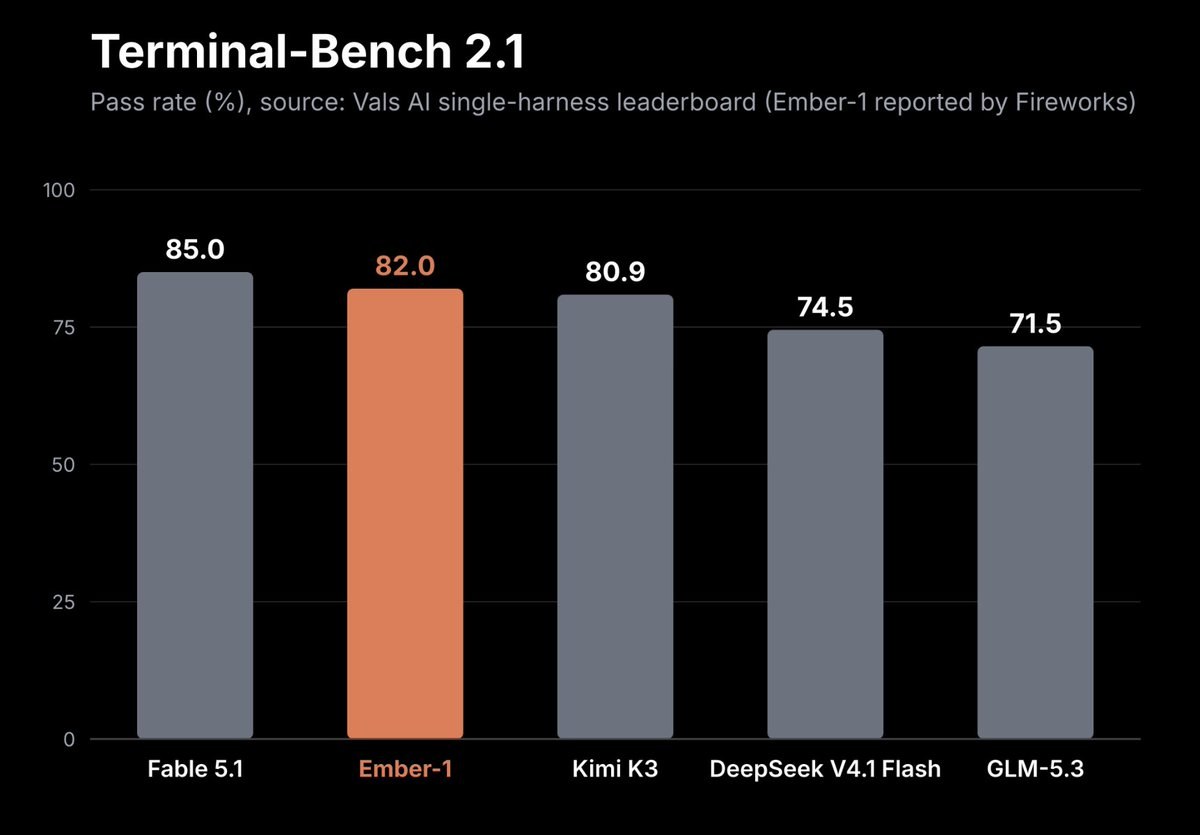
要点:@cline 介绍 Fireworks Research 的 Ember-1:基于 Kimi K3,在同等基准表现下大约少用 40% tokens;做法是后训练让模型少做重复思考。真实 coding 流量 A/B 里,推理 tokens 约少 71%、总 tokens 约少 39%,成功率持平。已在 Cline(含 Desktop)可用;@omarsar0 等也把这看成 token Pareto 前沿上值得跟的方向。
为何值得看:agent 循环里「想太多」正变成账单问题,专项后训练开始直接打这个点。
- Cline:https://x.com/cline/status/2104329978146115998
- Desktop:https://x.com/cline/status/2104329981191209235
- 评论:https://x.com/omarsar0/status/2104341259540123718
7. GitHub Copilot:App 里并行跑多个 agents
要点:@github 提醒:GitHub Copilot App 可并行跑多个 agents——每个会话独立 Git worktree 与上下文,可同时构建、审查、测试。
为何值得看:大厂默认客户端也在把「多 worktree 并行」做成一等能力,和独立 harness 的多会话叙事对齐。
8. DeepSeek Harness:dsh-better-sidebar 底座插件
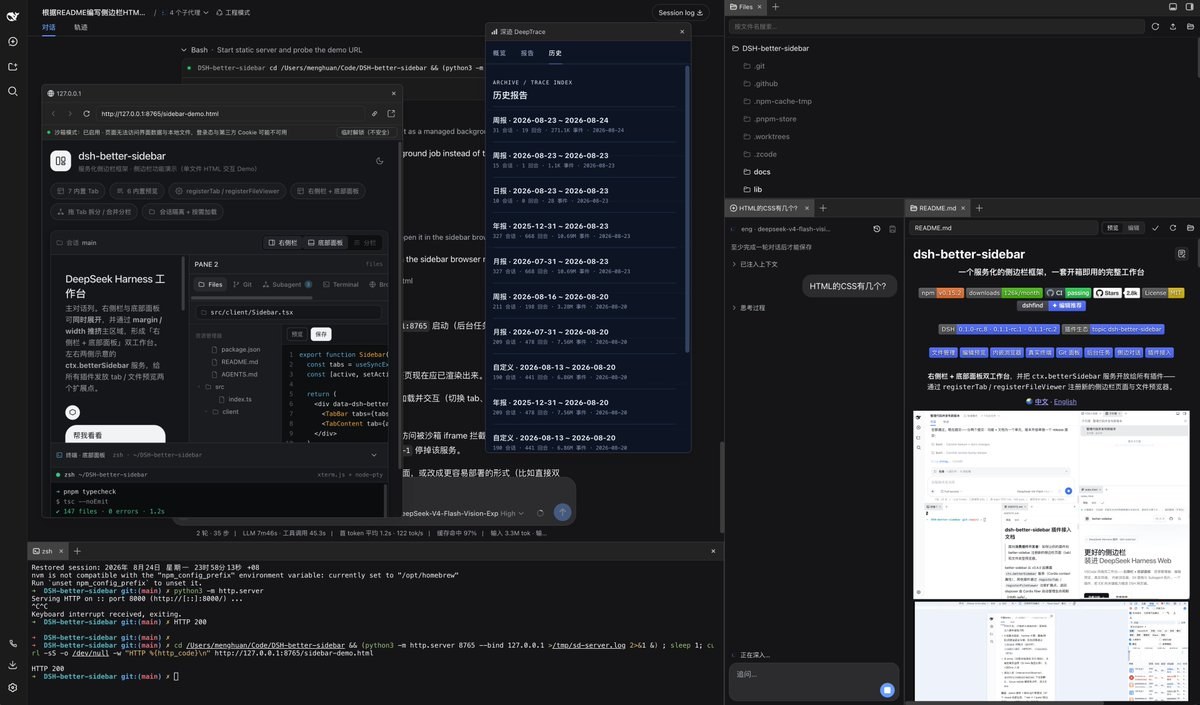
要点:@tianyi 继续 DSH 插件推荐,介绍 dsh-better-sidebar:为 DeepSeek Harness 增加侧边栏、底边栏、分栏、可浮动栏等 UI 定制,并作为给其它插件用的底座能力;在官方补了基础侧边栏后,该插件复用官方组件接口并继续扩展。承接此前「约 60% 用户装了第三方插件」的生态叙事。
为何值得看:国内 harness 把插件可组合性当成产品差异,而不只是模型壳。
9. Jev-as-a-Judge:用分类模型抓对齐失败
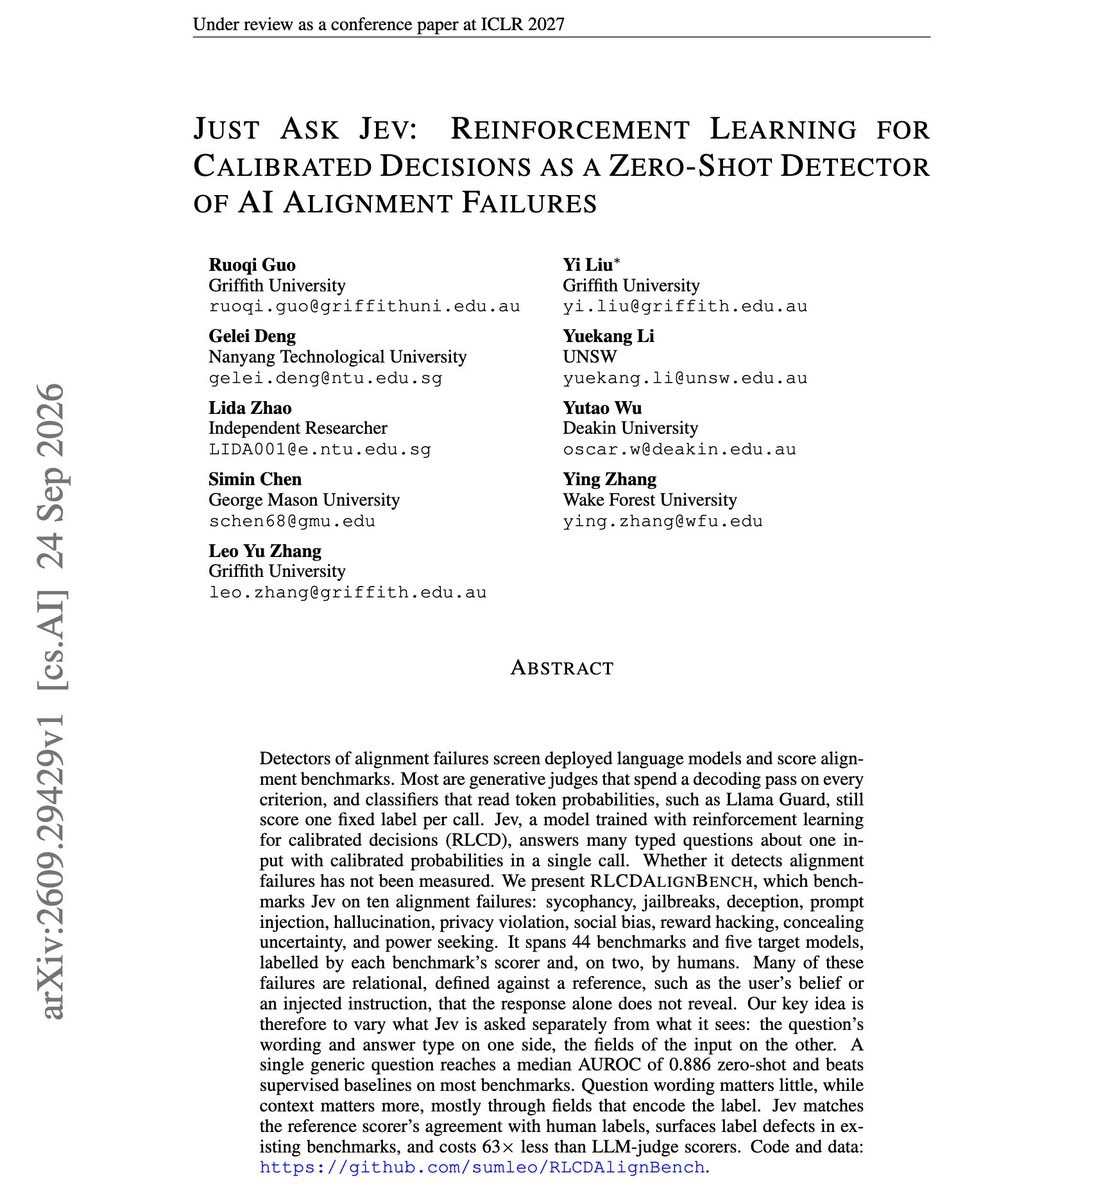
要点:@omarsar0 介绍用 Jev 做廉价对齐/失败检测:对模型回复问一个通用 yes/no,用概率当分数;无需额外训练,中位 AUROC 约 0.886;19 个基准上 Jev 一趟约 $0.30,而那些基准用的 LLM judge 约 $18.96。另帖强调 agent harness 时代,System One(分类)与 System Two(生成)混用值得认真做实验。
为何值得看:继 Jev Router 之后,Jev 又被推进「裁判/门禁」层——便宜、可校准的判定模型正在成为 harness 标配零件。
- 论文解读:https://x.com/omarsar0/status/2104295014117589053
- 分类模型回潮:https://x.com/omarsar0/status/2104235323970523543
10. Claude 封禁后:OpenCode + DeepSeek 成备胎栈
要点:@imwsl90 称账号被 Claude 封禁后反而想清楚了——日常大量其实吃的是 DeepSeek API;没有申诉计划,后续打算走 herdr + OpenCode + DeepSeek,整体比 Claude 便宜很多,并展示把 Omarchy 系统从 Claude 切到 OpenCode 只需几句话。这是中文时间线里「默认 harness 可替换」的现场样本。
为何值得看:当订阅账号成为单点故障,开源 harness + 国产/开源模型的可迁移性,比单一 SOTA 更有现实价值。